ARTT-HPA: Heterogeneity-Aware Autoscaling with Adaptive Resilient Thresholding and Traffic Allocation for Multi-Replica Microservices on Kubernetes (가제)
- On-going
- Co-Author
Summary
요청을 고르게 나눠도 상대적으로 성능이 낮은 노드의 파드는 먼저 과부하에 도달할 수 있습니다. ARTT-HPA는 요청량의 추세와 변동성으로 Threshold를 조정하고, 파드별 처리 여력에 맞춰 요청을 분배했습니다.
- Role
- 공동저자이기종 환경의 오토스케일링 후속 연구
- Outcome
- NASDAQ 실험에서 기본 HPA 대비 평균 P99 75.64% 감소. NASA-HTTP와 NASDAQ 모두 비교군 중 타임아웃 최소. 제출 준비 중.
scale-out만으로 해결되지 않는 노드별 과부하
ARTT-HPA는 LARE-HPA를 성능이 다른 노드가 섞인 이기종 클러스터로 확장한 후속 연구입니다.
기존 요청 분배 방식은 노드의 처리 성능 차이를 고려하지 않아, 상대적으로 성능이 낮은 노드의 파드에도 다른 파드와 같은 비율로 요청을 보냈습니다. 같은 요청량을 처리하더라도 이 파드들의 CPU 사용률이 더 높아져 먼저 과부하에 도달할 수 있습니다.
HPA는 전체 파드의 평균 CPU 사용률로 scale-out을 결정합니다. 따라서 일부 파드의 CPU 사용률이 높아도 평균값에는 그 상태가 충분히 드러나지 않을 수 있습니다. 실험에서는 300 RPS 부근에서 일부 파드의 CPU 사용률이 100%에 도달한 뒤에도 요청이 계속 배정돼 P99 지연이 급격히 증가했습니다. 파드 수 조정과 함께 처리 여력에 맞춘 요청 분배가 필요했던 이유입니다.
LARE-HPA의 Threshold 조정 방식에도 보완이 필요했습니다. 요청이 완만하게 증가하면 변동성 신호가 작아져 대응이 늦었고, 계절성이 없는 NASDAQ 부하에서는 누적 SLO 만족률이 기본 HPA보다 낮았습니다. 이에 요청량의 추세와 순간적인 변동을 분리해 Threshold에 반영하고, 노드별 요청 분배도 함께 조정했습니다.
추세와 변동성을 분리한 부하 분석
요청이 꾸준히 늘어나는 흐름을 추세로, 그 흐름에서 벗어나 오르내리는 정도를 변동성으로 구분했습니다. 두 신호에 각각 가중치를 부여해, 완만한 증가와 짧은 급증을 Threshold에 따로 반영하도록 했습니다.
일부 극단적인 관측값 때문에 추세가 크게 바뀌지 않도록 OLS 대신 RANSAC 회귀를 적용했습니다. 이상치 판정에는 중앙값을 기준으로 데이터가 얼마나 흩어져 있는지 보는 중앙값 절대편차(MAD)를 사용했습니다.
RANSAC은 여러 후보 회귀선을 만들고 MAD로 정한 허용 오차 안에 있는 관측값을 셉니다. 가장 많은 관측값을 설명하는 후보를 고른 뒤 해당 관측값으로 회귀선을 다시 맞춥니다. 일부 급격한 값이 전체 기울기를 바꾸는 영향을 줄이는 과정입니다.
추세 지표는 회귀선의 기울기이고, 변동성의 바탕은 관측값과 회귀선 사이의 평균 절대 잔차입니다. 요청이 꾸준히 늘지만 회귀선 주변의 흔들림은 작은 상황과, 평균 추세는 비슷하지만 순간적인 변화가 큰 상황을 서로 다른 신호로 다룹니다.
요청당 CPU 사용량을 반영한 Threshold
같은 수의 요청이 늘어도 노드에 따라 추가로 필요한 CPU가 다릅니다. 상대적으로 성능이 낮은 노드에서는 같은 요청을 처리하는 데 CPU를 더 사용할 수 있습니다. 이 차이를 반영하기 위해 변동성에 요청당 CPU 사용량을 곱하고, 그 결과를 Threshold 계산에 사용했습니다.
현재 지표를 평소 수준과 비교하려면 평균과 분산을 계속 갱신해야 합니다. Welford 온라인 알고리즘으로 새 관측값을 반영하고, 정규분포 분위수로 정한 구간 안의 값만 정규화 상한과 하한을 갱신하는 데 사용했습니다. 변동성은 음수가 될 수 없어 하한을 0으로 두고, 증가와 감소를 나타내는 추세는 양쪽 경계를 갱신합니다.
두 지표는 온라인으로 갱신한 하한과 상한을 기준으로 0~1 범위에 정규화했습니다. 변동성은 0 이상이지만 추세는 증가와 감소를 모두 나타내므로, 두 신호의 범위를 따로 관리합니다. 이 범위는 부하 이력이 쌓일 때마다 갱신해 초기 데이터만으로 이후 판단 기준이 고정되지 않도록 했습니다.
정규화한 추세와 변동성의 최근 변화량으로 동적 가중치를 구했습니다. 변화가 더 두드러진 신호에 큰 비중을 두고, 두 신호를 결합한 값이 커지면 Threshold를 낮춰 더 일찍 scale-out하도록 합니다. 반대로 안정적인 부하에서는 Threshold를 높입니다. 실험에서는 관측 구간 30개와 Threshold 50~100%를 사용했습니다.
다음 구간의 부하 예측에 따른 요청 분배
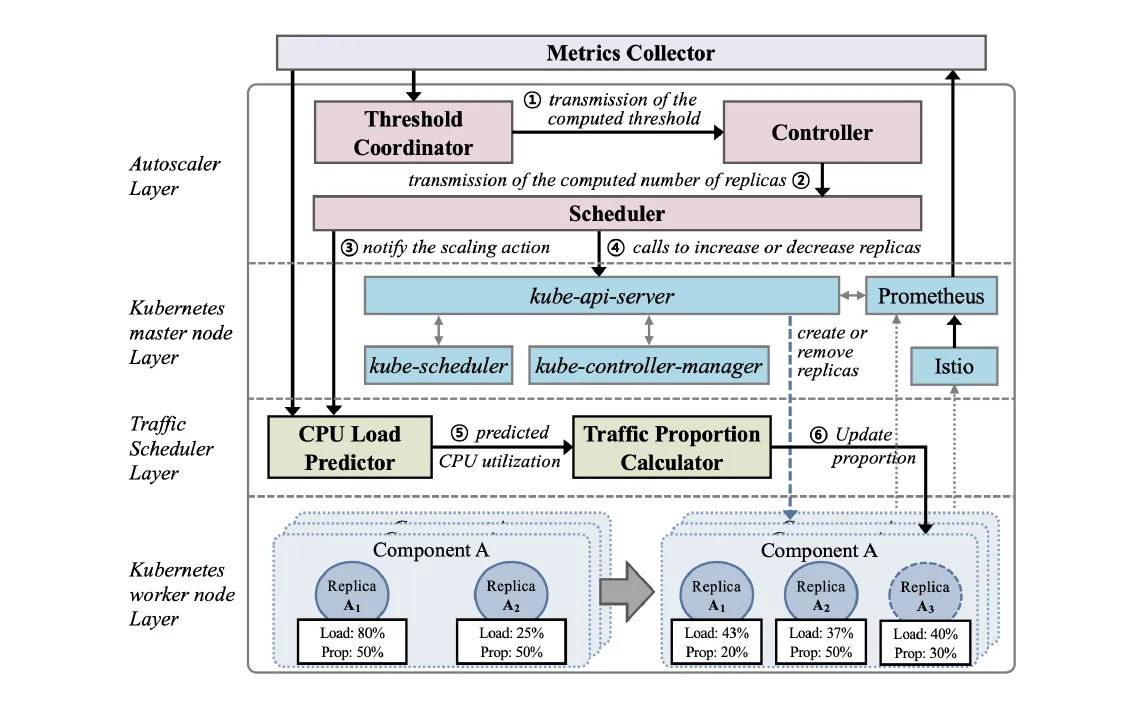
현재 활성 요청 수만으로는 각 파드가 다음 구간의 요청을 얼마나 처리할 수 있을지 판단하기 어렵습니다. Holt 이중지수평활로 파드별 다음 구간 CPU 사용률을 예측하고, 예상 부하가 큰 파드에는 요청을 덜 보내도록 비율을 조정했습니다.
Holt 모델은 현재 CPU 부하의 수준과 그 수준이 변하는 추세를 따로 갱신합니다. 다음 구간의 예측값은 두 값을 더해 구하므로, 현재 CPU 사용률이 같아도 상승 중인 파드와 하강 중인 파드의 예상 부하를 구분할 수 있습니다.
Holt의 평활 계수는 최근 관측값을 예측에 얼마나 반영할지 정합니다. 크면 빠르게 반응하지만 잡음에도 민감하고, 작으면 변화에 늦게 반응합니다. Kalman filter는 예측 상태의 불확실성과 관측 잡음으로 Kalman gain을 구해 수준과 추세의 갱신 계수로 사용합니다. 관측 잡음도 예측 잔차 제곱의 EWMA로 갱신해, 최근 오차가 달라질 때 두 계수가 함께 대응하도록 했습니다.
급격한 비율 변화와 새 파드의 관측 이력 부족에 대응
부하 차이를 요청 비율에 한 번에 반영하면 다음 구간에는 반대쪽으로 부하가 쏠릴 수 있습니다. sigmoid로 한 번에 조정하는 범위를 제한해 요청 비율의 반복적인 진동을 줄였습니다.
예측한 컴포넌트 평균 CPU 부하와 각 파드의 차이로 보정 계수를 구합니다. 실험에서는 sigmoid 보정 계수를 0.5~2 범위로 제한했습니다. 기존 요청 비율에 이 계수를 곱한 뒤 모든 파드의 비율 합이 1이 되도록 다시 정규화하므로, 보정 계수와 최종 요청 비율을 구분합니다.
scale-out으로 생성된 새 파드는 관측 이력이 부족해 초기 부하를 예측하기 어렵습니다. 같은 컴포넌트에서 이력이 충분한 파드의 값을 초기값으로 사용하는 warm-start를 적용했습니다. 이를 통해 관측값이 없다는 이유로 요청이 지나치게 적게 배정되는 것을 줄이고, 첫 구간부터 예측에 필요한 값을 확보했습니다. 전체 모듈은 애플리케이션 수정 없이 Kubernetes API와 연동하도록 구현했습니다.
계절성과 비계절성 부하를 나눠 검증한 실험
마스터 1대와 성능이 다른 워커 5대로 클러스터를 구성했습니다(Kubernetes 1.27.5, Istio 1.23.2, Prometheus 3.2.1). 크기가 다른 행렬곱을 순차 호출하는 마이크로서비스 5개를 배치하고, NASA-HTTP와 NASDAQ 부하에서 기본 HPA, LARE-HPA, Istio Least Request를 비교했습니다. SLO는 5초로 설정했습니다.
NASA-HTTP는 계절성이 있는 부하를, NASDAQ 자료에서 만든 요청 패턴은 비계절성 부하를 대표하도록 선택했습니다. 한 종류의 반복 패턴에만 맞는지 확인하는 대신, 자기상관 특성이 다른 두 부하에서 Threshold 조정과 요청 분배를 함께 평가했습니다.
응답 지연은 구간별 P99의 평균으로, 실패는 5초 타임아웃 요청 수로 따로 집계했습니다. CPU 활용률도 함께 측정해 응답 품질과 할당된 자원의 활용 정도를 나눠 비교했습니다.
NASDAQ 부하에서 기본 HPA보다 75.64% 낮아진 평균 P99 지연
NASDAQ 워크로드에서 평균 P99는 기본 HPA 4,180.0ms, Least Request 3,864.0ms, LARE-HPA 4,476.2ms에서 ARTT-HPA 1,018.3ms로 줄었습니다. 각각 75.64%, 73.65%, 77.25% 감소한 결과입니다. 두 워크로드 모두 5초 타임아웃 요청 수가 비교군 중 가장 적었습니다.
NASA-HTTP에서는 평균 P99만 보면 Least Request가 1,139.8ms로 ARTT-HPA의 1,763.5ms보다 낮았습니다. 그러나 타임아웃은 각각 5,364,327건과 4,391,250건으로 ARTT-HPA가 적었습니다. 실패한 요청은 지연시간 계산에서 빠질 수 있어, 응답한 요청의 지연과 실패 요청 수를 함께 비교했습니다.
전체 워크로드의 컴포넌트 평균 CPU 활용률은 50.22%로, 기본 HPA 32.50%, Least Request 46.43%, LARE-HPA 36.80%보다 높았습니다. 지연시간과 타임아웃을 줄이면서 할당된 CPU도 더 활용한 결과입니다. 현재 국제 학회 제출을 준비 중이며 제목은 가제입니다.
| 부하 | 기법 | 평균 P99 (ms) | 타임아웃 (건) |
|---|---|---|---|
| NASA-HTTP | HPA | 3,854.0 | 33,196,096 |
| NASA-HTTP | Least Request | 1,139.8 | 5,364,327 |
| NASA-HTTP | LARE-HPA | 3,248.3 | 9,436,492 |
| NASA-HTTP | ARTT-HPA | 1,763.5 | 4,391,250 |
| NASDAQ | HPA | 4,180.0 | 1,989,924 |
| NASDAQ | Least Request | 3,864.0 | 865,657 |
| NASDAQ | LARE-HPA | 4,476.2 | 2,109,292 |
| NASDAQ | ARTT-HPA | 1,018.3 | 386,277 |