Dynamic Replica Replacement Technique Based on Deep Reinforcement Learning for Cost-Effective Cluster Utilization in Heterogeneous Kubernetes Environment
Korea Computer Congress (KCC 2025)
Replica를 더 늘리는 대신, 같은 수의 Replica를 성능과 비용이 다른 노드에 어떻게 나눌지 살폈습니다. DQN이 지연시간과 비용을 함께 반영해 배치를 조정하도록 구성했습니다.
- 역할
- 공동저자 · 학부 연구생 멘토링
- 핵심 결과
- 워커 3대의 정적 배치 대비 평균·P95 지연을 비슷하게 유지하며, 활성 시간 기반 비용 모델에서 약 20% 절감.
배경
성능과 시간당 비용이 다른 노드에서는 같은 수의 파드를 실행해도 배치에 따라 지연시간과 비용이 달라집니다. 이 연구에서는 CPU 사용률뿐 아니라 응답 지연과 노드 비용을 함께 보고 배치를 조정하고자 했습니다.
이 논문은 전체 Replica 수는 그대로 둔 채 노드 간 분포만 실시간으로 다시 배치해, 비용은 줄이면서 성능은 지키는 것을 목표로 했습니다.
제안 기법
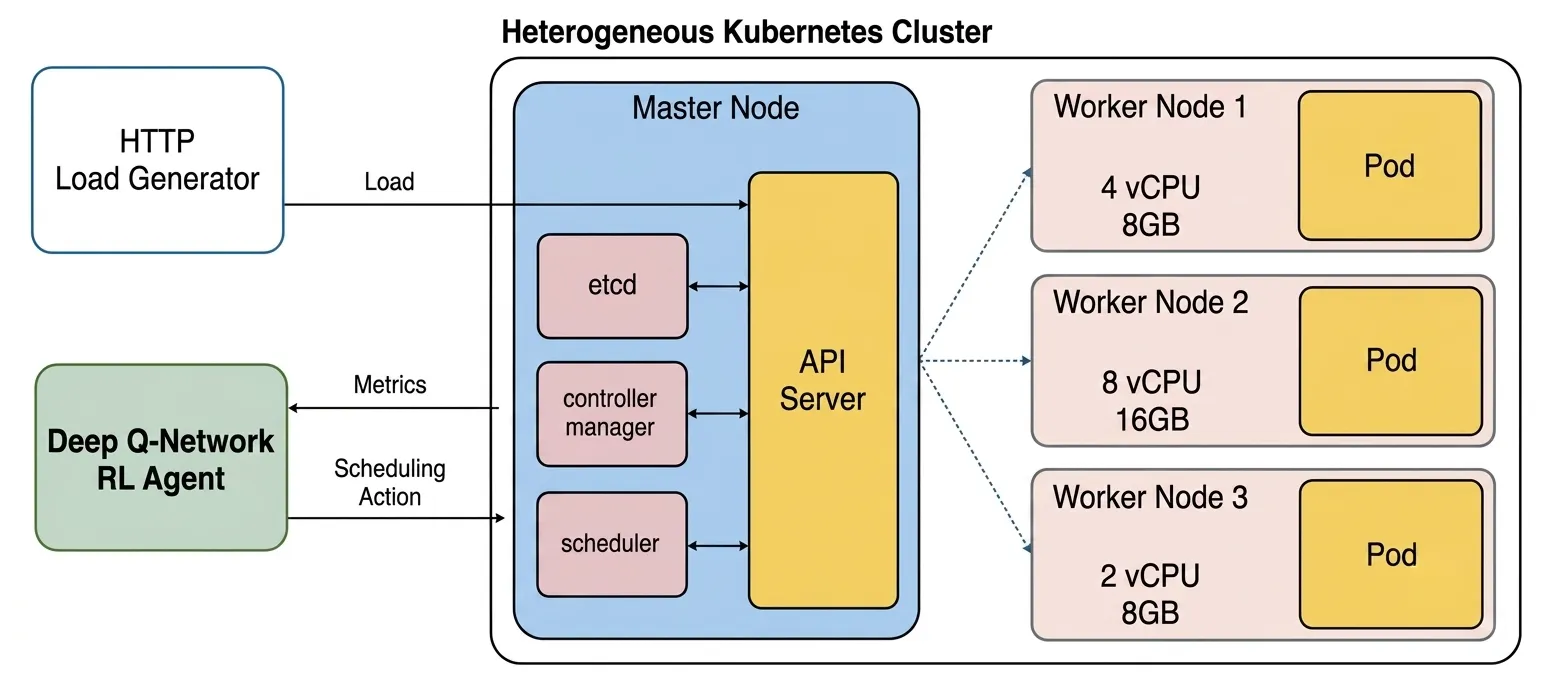
Deep Q-Network(DQN) 기반 강화학습 에이전트를 설계했습니다. 상태(state)는 각 워커 노드의 CPU 사용률·평균 응답 지연·현재 Replica 수로 구성되고(노드 3대 기준 9차원), 행동(action)은 각 노드의 Replica를 −1·0·+1로 조정하되 전체 합은 유지하는 이산 선택입니다. 보상(reward)은 평균 HTTP 응답시간, 노드별 CPU 사용량, 그리고 각 노드에 배치된 Replica 수와 그 VM의 시간당 비용을 함께 반영해 성능과 비용의 균형을 학습하도록 설계했습니다.
전체 Replica 수를 유지하면서 노드별로 −1·0·+1개를 옮기는 행동을 선택하므로 DQN을 적용했습니다. stable-baselines3의 MLP 정책망을 사용하고, ε-greedy 탐험·타깃 네트워크·경험 재플레이로 학습하도록 구성했습니다.
결과
텐센트 클라우드에 마스터 1대와 클럭이 서로 다른 워커 3대(시간당 $0.15·$0.31·$0.12)로 이기종 클러스터를 만들고, CPU 집약적인 PHP 행렬곱 서비스에 vegeta로 15초 간격 부하를 주며 Prometheus·Istio로 지표를 수집했습니다. 비교군은 모든 워커에 Replica를 1개씩 고정한 정적 배치(기본 스케줄링)입니다.
DQN 기반 재배치는 정적 배치와 비슷한 평균·P95 지연을 유지하면서 비용 모델상 약 20%를 절감했습니다. 비용은 워커의 활성 시간과 시간당 단가를 곱해 비교했습니다.
이 비교에서는 Replica를 추가하지 않고도 노드별 배치 비율을 바꿔 성능을 유지하며 비용을 줄일 수 있었습니다. 저는 학부 연구생을 지도하며 공동저자로 참여했습니다.