HEART: Heterogeneous-Aware Traffic Allocation in Multi-Replica Deployments on Kubernetes
2025 IEEE 18th International Conference on Cloud Computing (CLOUD)
- SCIE-compatible top-tier
Summary
가까운 파드에 요청을 집중하면 과부하가 생기고, 고르게 나누면 느린 통신 경로가 남을 수 있습니다. 노드별 처리 여력과 통신 지연을 나눠 계산해 요청 비율과 경로를 함께 조정했습니다.
- Role
- 제2저자LATA 후속 연구의 공동 설계와 구현
- Outcome
- DAG, 400 RPS, 노드 간 지연 1ms 미만에서 P99 82ms. 400개 Replica의 스케줄링 계산 시간 9.4ms.
같은 비율로 요청을 나눠도 달라지는 노드별 부하
마이크로서비스는 같은 컴포넌트를 여러 파드로 실행합니다. 요청을 고르게 나눠도 상대적으로 성능이 낮은 노드에 배치된 파드는 먼저 과부하에 도달할 수 있습니다. 노드 간 통신 지연도 다르기 때문에 요청을 어느 파드로 보내는지에 따라 응답시간이 달라집니다. HEART는 파드의 처리 여력과 통신 경로를 함께 고려해 P99 지연을 줄이는 연구입니다.
노드 간 지연이 1ms 미만인 환경에서도 기본 분배 방식의 P99는 100 RPS에서 최대 4,010ms였습니다. 활성 요청 수를 기준으로 분배하는 Istio Least Request는 293ms로 낮았지만, 상대적으로 성능이 낮은 노드에서는 CPU 사용률이 순간적으로 100%를 넘었습니다. 요청당 CPU 사용량도 약 12.3% 변동해, 현재 부하뿐 아니라 다음 구간의 변화도 반영할 필요가 있었습니다.
통신 지연을 고려한 이전 연구 LATA도 느린 링크를 남기는 경우가 있었습니다. 링크 하나를 제외하자 가장 오래 걸리는 경로의 지연이 100ms에서 80ms로 줄어, 요청 비율을 계산하기 전에 느린 링크를 걸러보기로 했습니다. 동시에 Replica 수가 100개에서 400개로 늘 때 계산 시간이 8.8ms에서 98.1ms로 증가하는 문제도 줄여야 했습니다.
처리 여력과 통신 지연을 나눠 계산하는 요청 분배
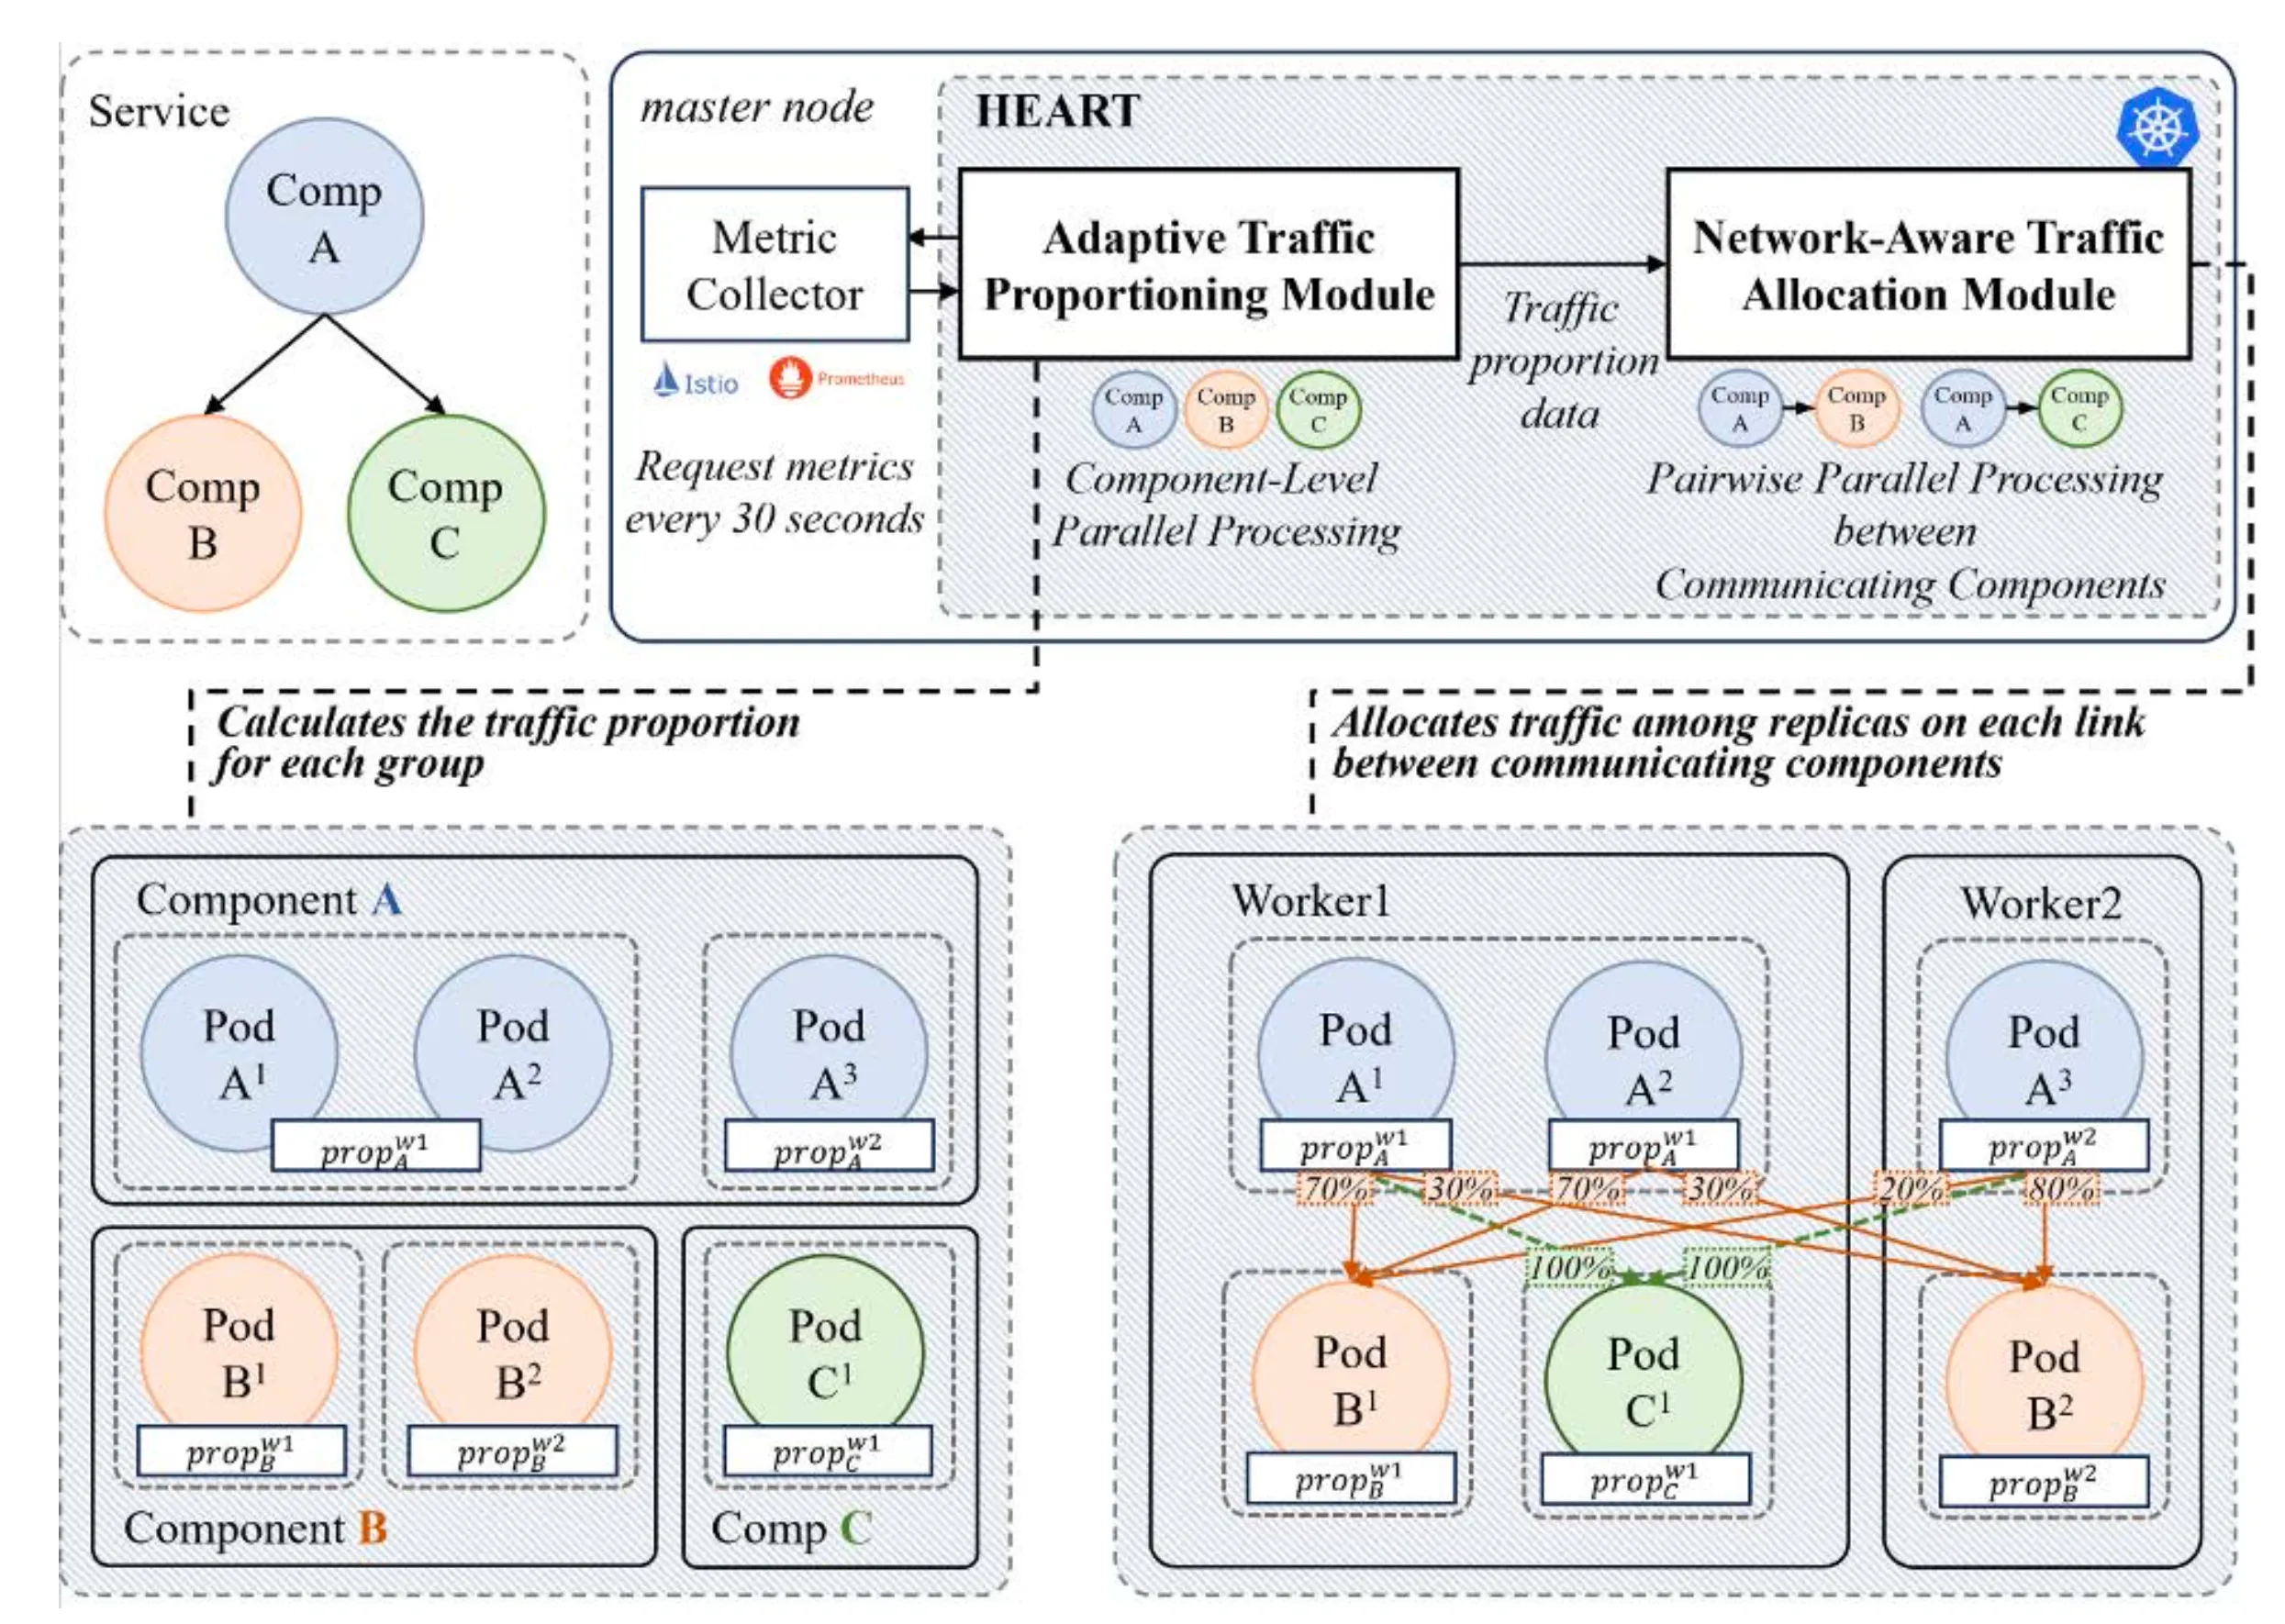
HEART는 요청을 얼마나 나눠 보낼지와 어느 경로로 보낼지를 두 단계로 계산합니다. ATPM이 먼저 노드별 처리 여력에 맞춰 그룹별 요청 비율을 정합니다. NTAM은 그 비율을 지키면서 통신 지연이 작은 경로를 선택합니다. 이 과정을 30초마다 반복해 요청 분배를 갱신합니다.
Metric Collector는 Prometheus exporter로 파드별 CPU 사용량, 요청 수, 노드 간 지연, 컴포넌트 간 호출 관계를 수집합니다. ATPM과 NTAM이 같은 관측값을 함께 사용하도록 구성했습니다.
ATPM: 부하 추세에 맞춰 정하는 그룹별 요청 비율
같은 컴포넌트의 파드를 배치된 노드별로 묶었습니다. 개별 파드 대신 그룹 단위로 계산하면 다음 단계에서 다뤄야 할 링크 수를 줄일 수 있습니다. 부하는 요청당 CPU 사용량으로 구하고, 처리한 요청이 없는 파드는 해당 계산에서 제외했습니다.
그룹 부하는 유효한 파드들의 요청당 CPU 사용량 평균을 그룹의 전체 Replica 수로 나눠 계산합니다. 같은 노드에서 실행되는 파드들의 처리 특성이 비슷하더라도, Replica 수가 많은 그룹은 더 많은 요청을 나눠 처리할 수 있기 때문입니다.
최근 부하를 얼마나 반영할지에 따라 예측이 늦어지거나 일시적인 변화에 과민하게 반응할 수 있습니다. EWMA는 새 부하와 직전 추정값을 가중 평균하는 방식이며, 새 부하에 주는 계수 α를 최근 변동에 따라 갱신하도록 했습니다.
그룹 부하의 최근 30개 관측값에서 평균을 구하고, 각 값이 평균에서 벗어난 정도의 제곱을 평균해 MSE를 계산합니다. MSE 이력도 같은 길이로 유지하며, 그 안에서 현재 MSE를 Min-Max 정규화해 EWMA 계수를 정합니다. 실험에서 비교한 후보 중 0.2~0.8 범위를 선택해 새 관측값을 거의 무시하거나 전부 반영하는 극단을 피했습니다.
그룹별 요청 비율은 예측 부하의 역수를 구해 그 합으로 정규화합니다. 예측 부하가 낮은 그룹은 더 큰 비율을 받고, 높은 그룹은 더 작은 비율을 받습니다. 각 그룹의 비율 합은 1로 유지해 다음 단계의 송신량과 수신량 제약으로 사용합니다.
유효한 관측이 없는 기존 그룹은 직전 EWMA를, 새 그룹은 다른 유효 그룹의 평균을 사용합니다. 전체 값이 0이면 균등 분배해 관측값이 없는 경우에도 요청을 배정할 수 있도록 했습니다. 그룹별 부하와 요청 비율은 컴포넌트별로 병렬 계산합니다.
NTAM: 필요한 요청량을 유지하며 느린 경로 제거
NTAM은 ATPM이 정한 비율만큼 요청을 전달할 경로를 찾습니다. Minimum-Cost Flow(MCF)는 전체 통신 비용을 줄이지만, 일부 요청이 오래 걸리는 경로를 사용할 가능성은 남습니다. 그래서 느린 링크를 먼저 제거하고 남은 경로에서 요청 비율을 계산하도록 했습니다.
상위 컴포넌트의 그룹을 공급 정점, 하위 컴포넌트의 그룹을 수요 정점으로 둔 이분 그래프를 구성했습니다. 각 그룹의 송수신량은 ATPM의 비율로 고정하고, 링크 비용에는 노드 간 지연을 사용합니다. 링크 용량은 해당 공급량과 수요량 중 작은 값으로 두었습니다.
k-means로 링크를 지연이 큰 그룹과 작은 그룹으로 나눴습니다. 지연이 큰 그룹의 링크 수가 더 적으면 한꺼번에 제거한 뒤 필요에 따라 복구하고, 더 많거나 같으면 느린 링크부터 하나씩 제거합니다. 필요한 요청량을 모두 전달할 수 없게 되면 직전의 가능한 구성으로 돌아갑니다.
Maximum Flow는 남은 링크로 요청량 전체를 전달할 수 있는지 확인하는 단계입니다. 그 조건을 통과한 그래프에 MCF를 적용해 지연 비용을 줄입니다. 링크 제거의 가능 여부와 남은 경로의 비용 최적화를 분리해, 지연을 줄이려다 필요한 트래픽이 끊기는 상황을 피했습니다.
검증을 통과한 그래프에 MCF를 적용해 트래픽 양과 지연시간을 곱한 총비용을 최소화합니다. 그룹 간 요청량은 해당 그룹의 파드 쌍에 균등하게 나눠 실제 분배 비율로 변환합니다. 느린 링크를 걸러내는 단계만 적용한 비교에서도 P99가 평균 7.5% 줄었습니다.
-
처리 여력에 맞춰 그룹별 비율 계산
같은 노드의 Replica를 묶고 요청당 CPU 부하와 Replica 수를 반영합니다. EWMA로 다음 구간의 부하를 추정하며, 유효한 관측이 없으면 이전 값, 기존 그룹 평균, 균등 분배 규칙을 적용합니다.
-
느린 경로를 제거할 후보로 분류
노드 간 지연을 두 그룹으로 나눕니다. 지연이 큰 링크가 적으면 먼저 모두 제거하고, 많으면 지연이 큰 순서로 하나씩 제거합니다.
-
요청을 모두 전달할 수 있는지 확인
MaxFlow로 필요한 송신량과 수신량을 만족하는지 검사합니다. 부족하면 링크를 복구하거나 마지막으로 가능한 구성으로 돌아갑니다.
-
남은 경로에서 통신 비용 최소화
가능한 그래프에 Minimum-Cost Flow를 적용하고, 그룹별 할당을 개별 Replica의 라우팅 비율로 나눕니다.
노드 성능과 통신 지연을 함께 바꿔 비교한 실험
HEART는 Go 1.22.6로 구현하고 마스터 1대, 워커 5대의 이기종 Kubernetes 1.27.5 환경에서 평가했습니다. 두 컴포넌트가 연결된 pairwise application과 여러 컴포넌트가 연결된 DAG application을 나눠, 호출 관계가 복잡해졌을 때의 효과도 비교했습니다.
노드 간 지연이 1ms 미만인 조건과 지연을 다르게 설정한 Scenario A, B에서 기본 Kubernetes, Istio Least Request, OptTraffic, LATA를 비교했습니다. 부하 변화에 따른 P99와 CPU 분포를 함께 확인하고, 추세 분석을 제거한 HEART와의 ablation 실험으로 ATPM의 기여를 따로 살폈습니다.
Replica 수가 늘어날 때 스케줄링 계산이 요청 분배 주기를 방해하는지도 평가했습니다. 100개부터 400개까지 확장하며 계산 시간을 비교해, 그룹화와 컴포넌트별 병렬 처리의 효과를 확인했습니다.
P99 82ms와 Replica 400개의 계산 시간 9.4ms
두 컴포넌트가 통신하는 pairwise application에서 HEART는 기본 Kubernetes 대비 P99를 약 95.2% 낮췄습니다. Least Request와 비교해도 P99가 293ms에서 194ms로 줄었습니다. 50~200 RPS 구간에서도 안정적인 응답을 유지했고, 상대적으로 성능이 낮은 노드에 배치된 Replica의 CPU 사용률이 고르게 분포해 부하 분산 효과를 확인했습니다. 통신 지연이 큰 Scenario B의 50 RPS에서는 OptTraffic 502ms, LATA 440ms, HEART 357ms였습니다.
여러 컴포넌트가 연결된 DAG application에서는 차이가 더 컸습니다. 노드 간 지연 1ms 미만, 400 RPS 조건에서 P99는 기본 Kubernetes 30,620ms, Least Request 768ms, OptTraffic 1,580ms, LATA 1,450ms, HEART 82ms였습니다. 부하를 200 RPS에서 400 RPS로 늘렸을 때 HEART는 60ms에서 82ms로 22ms 증가한 반면, 기본 Kubernetes는 약 61배 증가했습니다. 기존 기법의 CPU 사용률이 최저 27%, 최고 103%로 벌어진 조건에서도 HEART의 컴포넌트별 최대와 최소 차이는 평균 약 3%p였습니다.
부하 추세 분석을 제거하는 ablation 실험도 수행했습니다. 추세를 반영했을 때 Scenario A의 P99는 366ms에서 176ms로 약 51.9%, Scenario B는 528ms에서 241ms로 약 54.4% 줄었습니다. 복합 부하에서 CPU 사용률의 최대와 최소 차이는 추세를 반영하면 약 15%p, 제거하면 약 75%p였습니다.
Replica 수를 100개에서 400개로 늘리자 LATA의 스케줄링 계산 시간은 8.8ms에서 98.1ms로, HEART는 6ms에서 9.4ms로 증가했습니다. 개별 Replica를 노드별 그룹으로 묶고, 컴포넌트와 컴포넌트 쌍 단위로 병렬 계산해 증가 폭을 줄였습니다.
저는 LATA에 이어 공동 설계와 구현에 참여했으며, 논문은 IEEE CLOUD 2025에 게재됐습니다.
검증 범위는 안정적인 노드 환경에서 최대 400개 Replica까지였습니다. 30초 주기의 갱신 사이에 발생하는 장애에는 즉시 대응하기 어려워, 장애 이벤트 연동과 오토스케일링 결합을 후속 과제로 남겼습니다.
| 실험 조건 | 비교 대상 | 비교값 (ms) | HEART (ms) |
|---|---|---|---|
| DAG · 400 RPS · 지연 <1ms | 기본 Kubernetes · P99 | 30,620 | 82 |
| 동일 조건 | Least Request · P99 | 768 | 82 |
| 추세 분석 제거 · Scenario A | HEART no trend · P99 | 366 | 176 |
| 추세 분석 제거 · Scenario B | HEART no trend · P99 | 528 | 241 |
| Replica 400개 | LATA · 스케줄링 계산 | 98.1 | 9.4 |