LARE-HPA: Co-optimizing Latency and Resource Efficiency for Horizontal Pod Autoscaling in Kubernetes
22nd International Conference on Service-Oriented Computing
- Distinguished Paper (Top 6)
- SCIE-compatible Top-tier
확장 기준을 낮추면 응답은 빨라지지만 자원을 오래 남겨두게 됩니다. 요청의 변동성과 추세를 따로 분석해, 확장할 시점과 자원을 회수할 시점을 함께 조정했습니다.
- 역할
- 제1저자 · LARE-HPA 연구 수행
- 핵심 결과
- NASA-HTTP 실험에서 기본 HPA 대비 평균 지연 50.34% 감소, SLO 만족률 93.86% → 97.24%. 자원 사용은 약 9.5% 증가.
고정된 확장 기준으로는 부하 변화에 대응하기 어려웠습니다
CPU 기반 HPA는 평균 CPU 사용률과 설정한 목표값의 비율로 필요한 Replica 수를 계산합니다. 축소 시에는 안정화 구간의 권고값을 고려해 짧은 부하 감소만으로 파드가 사라지는 것을 막습니다. 이 연구는 CPU 목표값과 자원 유지 시간을 고정했을 때 생기는 성능·자원 사용의 차이에서 출발했습니다.
CPU 임계값을 낮추면 일찍 확장해 응답 지연을 줄일 수 있지만 자원 사용이 늘어납니다. 실험에서도 낮은 임계값을 적용했을 때 CPU 사용량이 약 22% 증가했습니다. 반대로 높게 설정하면 자원은 적게 쓰지만, 지표를 수집하는 사이에 부하가 늘어 확장이 늦어질 수 있습니다. 축소 대기 시간도 길면 불필요한 파드가 남고, 짧으면 파드를 줄인 직후 다시 늘리는 일이 반복됩니다.
요청이 꾸준히 늘 때와 짧게 급증할 때 필요한 설정은 다릅니다. 한 번 정한 임계값과 대기 시간으로 두 상황에 계속 대응하기 어려웠습니다. 신규 애플리케이션은 분석할 이력도 부족했기 때문에, 실행 중 쌓이는 요청 데이터를 보고 두 값을 조정하도록 설계했습니다.
사전 데이터 없이 부하를 예측해야 했습니다
신규 애플리케이션에서도 예측을 시작하려면 충분한 학습 데이터가 쌓일 때까지 기다리기 어려웠습니다. 사전에 수집한 데이터로 학습하는 Bi-LSTM 대신, 요청이 들어오는 대로 모델을 갱신하는 방식을 검토했습니다.
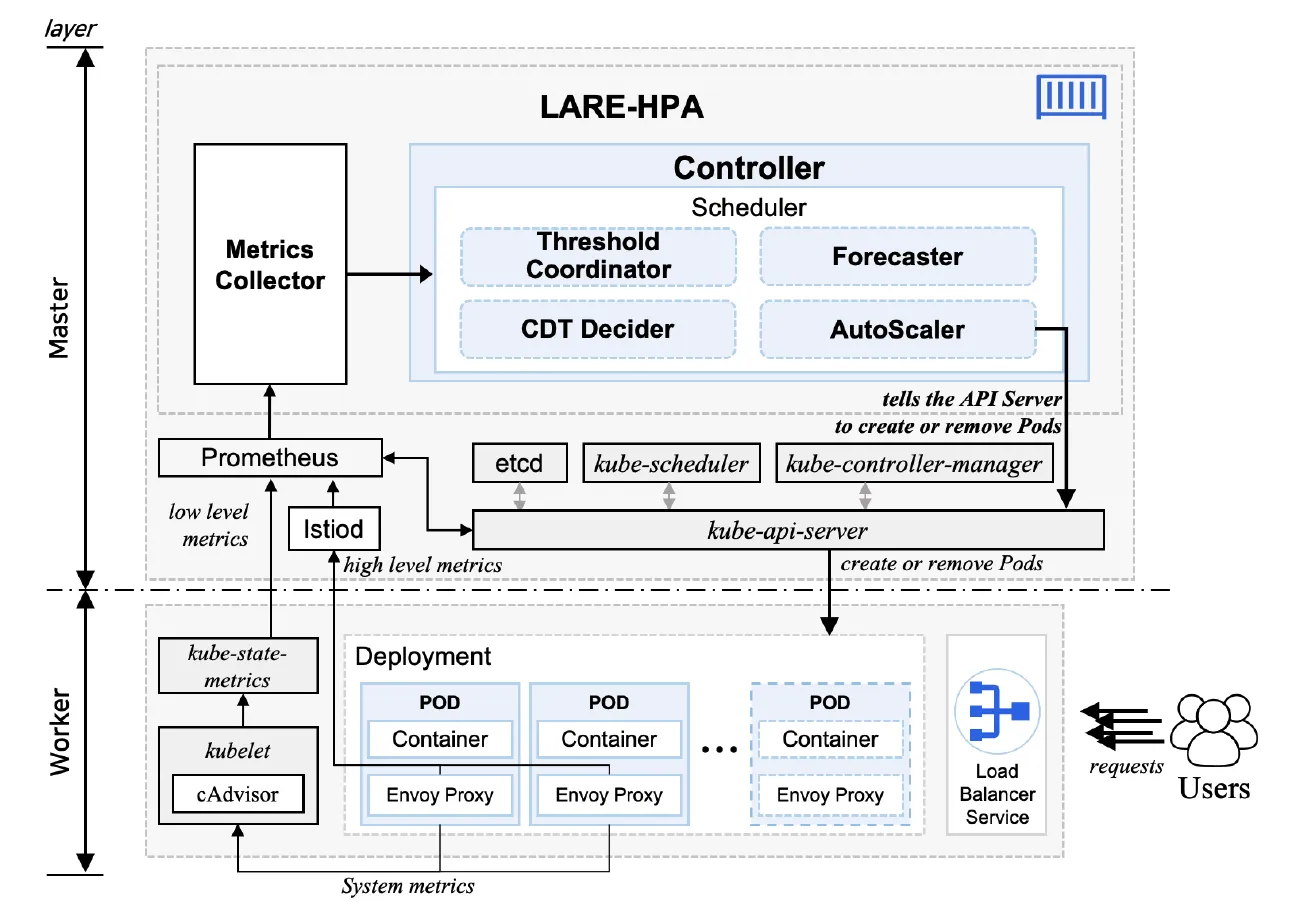
온라인 ARIMA를 적용하고 하나의 컨트롤러 Pod로 배포했습니다. Prometheus에서 시스템 지표와 Istio Envoy의 요청 지표를 읽고, 기존 Replica 수 계산식에 넣는 CPU 임계값과 축소 대기 시간을 매 주기 조정하도록 구성했습니다.
관측할 때마다 예측 모델을 갱신했습니다
온라인으로 ARIMA를 갱신할 때는 직접 관측할 수 없는 잡음항을 다루어야 합니다. 기존 Online ARIMA 연구의 근사 방식을 적용해 이동평균 항 대신 자기회귀 차수를 늘리고, 관측 가능한 요청 이력으로 다음 값을 예측하도록 구성했습니다.
기존 Online ARIMA의 Online Newton-Step으로 계수를 갱신했습니다. 새 관측값마다 예측 오차를 반영하므로 전체 이력을 다시 학습할 필요가 없습니다. 이렇게 얻은 예측값을 CPU 임계값과 자원 유지 시간 조정에 연결했습니다.
변동이 클 때 먼저 확장하도록 기준을 바꿨습니다
서비스마다 요청량 규모가 달라 절대 요청 수만으로 확장 기준을 정하기는 어려웠습니다. 과거와 비교해 변동이 얼마나 큰지 계산하고 CPU 임계값으로 변환했습니다. 실험에서는 임계값의 조정 범위를 50~95%로 설정했습니다.
최근 요청 변화량의 평균에 예측 오차를 더해 변동성을 구했습니다. 예측이 빗나간 정도도 확장 판단에 반영하기 위해서입니다. 이 값을 애플리케이션의 과거 변화 분포와 비교한 z-score로 바꿔, 현재 변동이 평소보다 큰지 작은지 판단했습니다.
z-score를 역방향 sigmoid에 넣어 변동이 클수록 임계값은 낮아지도록 했습니다. 급변할 때는 먼저 확장하고, 부하가 안정적일 때는 임계값을 높여 기존 파드의 자원을 더 활용합니다. sigmoid는 입력이 극단적으로 커져도 출력이 설정 범위를 벗어나지 않아 임계값의 급격한 변화를 제한할 수 있습니다.
요청 추세를 보고 자원 유지 시간을 조정했습니다
축소 대기 시간은 최근 요청량에 적합한 선형회귀의 기울기로 조정했습니다. 상승 추세에서는 잠깐의 부하 감소만으로 파드를 줄이지 않도록 대기 시간을 늘렸습니다. 하강 추세에서는 대기 시간을 줄여 남는 자원을 더 일찍 반납하도록 했습니다.
회귀 기울기만으로 대기 시간을 바꾸지 않도록 잔차의 자기상관도 확인했습니다. Durbin–Watson 통계량이 연구에서 정한 허용 구간에 있을 때만 상승·하락 추세에 따라 카운터를 한 단계 조정합니다. 조건을 만족하지 않으면 추세에 따른 조정을 보류합니다.
확장은 빠르게, 축소는 조건을 확인한 뒤 실행했습니다
파드를 줄였다가 다시 준비하려면 컨테이너 시작과 지표 수집을 기다려야 합니다. 따라서 확장은 바로 요청하되, 축소는 대기 카운터가 끝나고 요청 추세도 상승하지 않을 때만 실행하도록 했습니다.
애플리케이션 코드를 바꾸지 않고 Kubernetes API로 Replica 수를 갱신하는 독립 컨트롤러로 구현했습니다. Prometheus·Istio·kube-state-metrics의 관측 데이터를 사용하며, 임계값 범위와 관측 구간은 설정으로 관리합니다.
-
요청 변화를 확장 기준으로 변환
온라인 예측과 최근 요청 변화량으로 변동성을 구하고, 과거 대비 상대적인 크기를 설정한 CPU 임계값 범위에 매핑합니다.
-
추세에 따라 자원 유지 시간 조정
최근 요청의 회귀 추세와 잔차를 확인합니다. 판단 조건을 만족하면 상승 추세에서는 대기 시간을 늘리고, 하락 추세에서는 줄입니다.
-
필요한 Replica 수 계산
현재 Replica 수 × 현재 평균 CPU 사용률 ÷ 조정한 임계값을 올림하고, 설정한 최소·최대 Replica 범위로 제한합니다.
-
확장과 축소의 조건을 다르게 적용
확장은 즉시 요청합니다. 축소는 대기 시간이 끝나고 상승 추세가 아닐 때만 요청한 뒤 대기 카운터를 갱신합니다.
결과
변동이 큰 구간을 포함한 NASA-HTTP 요청 이력을 PHP 삼각함수 연산 서비스에 적용하고, 기본 HPA·offline Bi-LSTM·Online Bayesian Optimization(Microscaler)과 비교했습니다. SLO는 1초입니다. 평균 지연시간은 HPA의 562.8ms에서 279.5ms로 50.34% 줄었고, Bi-LSTM·Online-BO 대비로도 각각 39.52%·46.18% 낮았습니다. SLO 만족률은 93.86%에서 97.24%로 3.38%p 높아졌습니다.
리소스는 기본 HPA 대비 약 9.5% 더 사용했지만, over-provisioning으로 HPA의 2배를 사용한 Online-BO보다 훨씬 효율적이었습니다. Bi-LSTM은 학습하지 못한 급변에서 성능이 저하됐고, Online-BO는 scaling trigger가 늦게 동작해 급증을 놓쳤습니다. 이 연구는 제가 제1저자로 수행해 SCIE급 최상위 학회 ICSOC 2024에서 Distinguished Paper(Top 6)로 선정됐으며, 특허 출원과 소프트웨어 저작권 등록을 완료했고 코드는 open source로 공개돼 있습니다.
| 기법 | 평균 지연 (ms) | SLO 만족률 | 자원 (millicore) |
|---|---|---|---|
| HPA | 562.8 | 93.86% | 582.76 |
| LARE-HPA | 279.5 | 97.24% | 638.13 |
| Bi-LSTM | 462.1 | 93.06% | 875.85 |
| Online-BO | 519.3 | 95.15% | 1,274.75 |
특허 출원(10-2024-0128875) 및 소프트웨어 저작권 등록(C-2024-043831).