Proactive Auto Scaling Based on Marginal Request Change Analysis for Reducing Tail Latency in Kubernetes Cluster
International Conference on Innovative Computing
Summary
CPU가 Threshold에 도달한 뒤에는 이미 요청이 밀려 있을 수 있습니다. p-HPA는 요청 증가 속도와 현재 CPU 사용률로 추가 파드 수를 계산해 급증에 더 일찍 대응합니다.
- Role
- 제1저자선제적 오토스케일링 연구
- Outcome
- 선형, 주기, 지수형 부하와 CPU Threshold 70%, 80%, 90% 조합에서 지연 감소. 평균 자원 사용은 HPA 대비 약 13% 증가.
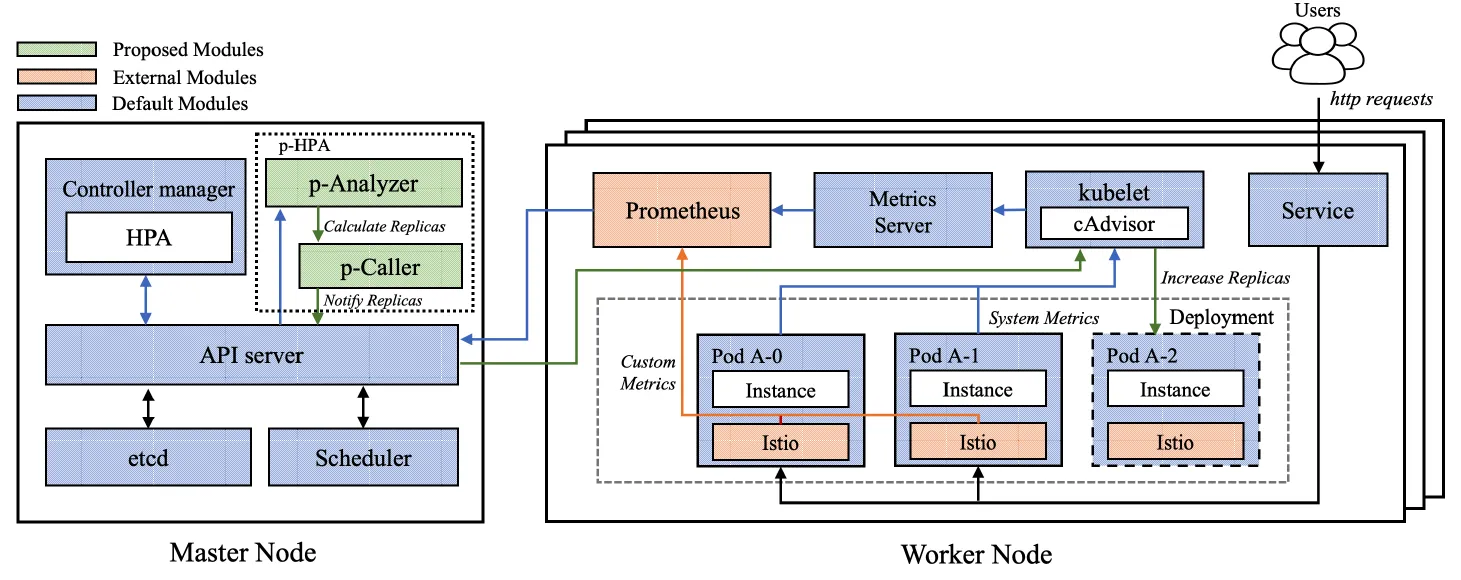
CPU Threshold만으로는 제때 대응하기 어려운 요청 급증
CPU 기반 HPA는 현재 사용률과 목표 Threshold를 비교해 파드 수를 조정합니다. Threshold가 낮으면 일찍 확장하지만 자원을 더 쓰고, 높으면 부하가 충분히 오른 뒤에야 확장합니다.
실험 환경에서 CPU 지표는 15초마다 수집됐습니다. 그 사이 요청이 급증하면 기존 파드에 부하가 쌓인 뒤 확장이 시작될 수 있었습니다. CPU Threshold만 조정하기보다, 요청의 증가 속도를 함께 보고 더 일찍 파드를 준비하는 방법을 검토했습니다.
LSTM과 Bi-LSTM은 먼저 학습 데이터를 모으고 모델을 학습해야 합니다. p-HPA는 장기 패턴 예측 대신 운영 중 들어오는 요청의 급증을 감지하는 데 집중해 이 준비 과정을 생략했습니다.
CPU Threshold에 앞서 살펴보는 요청 증가 속도
p-HPA는 요청이 얼마나 빠르게 늘고 있는지 살핍니다. 현재 CPU 사용률만으로는 놓치기 쉬운 급증을 요청 변화량으로 먼저 감지하고, CPU가 Threshold에 도달하기 전에 파드를 추가하도록 했습니다.
Istio에서 서비스별 요청 수를 수집해 Prometheus로 전달했습니다. p-Analyzer는 이 지표로 추가 Replica 수를 계산하고, p-Caller는 Kubernetes API로 확장을 요청합니다. 두 모듈은 기존 HPA와 함께 동작하도록 배치했습니다.
arctan으로 정규화한 요청 변화량
요청 증가분은 매우 커질 수 있어 그대로 비교하면 판단 기준도 크게 흔들립니다. arctan으로 증가분을 제한된 각도 범위로 변환했습니다. 요청이 빠르게 늘수록 큰 각도가 나오지만 값이 무한히 커지지는 않아, 증가 속도를 같은 범위에서 비교할 수 있습니다.
p-Analyzer는 60초 간격의 요청 수 차이를 시간으로 나눈 뒤 arctan을 적용하고, 결과를 −90~90도 범위로 변환합니다. 양수는 증가, 음수는 감소를 나타내며 증가가 가팔라질수록 90도에 가까워집니다. 원시 요청 수의 단위 대신 이 정규화한 변화량으로 관측 구간을 정합니다.
요청이 급증할수록 짧아지는 모니터링 구간
최근 몇 구간을 볼지도 요청 변화에 맞춰 조정했습니다. 긴 구간을 보면 급증에 늦게 반응하고, 짧은 구간만 보면 일시적인 변화에 민감해지기 때문입니다.
가장 최근 구간부터 과거로 이력을 넓히며 정규화한 변화량을 누적했습니다. 원문 알고리즘의 기준값 90에 도달하면 누적값을 선택한 구간 수로 나눠 평균 증가 속도를 구합니다. 급증할수록 짧은 구간에서 기준에 도달하고, 완만한 증가에서는 더 긴 이력을 참고합니다.
이렇게 정한 관측 구간은 고정 길이의 평균이 급증을 희석하는 문제를 줄입니다. 동시에 단일 구간의 요청 수만으로 확장을 결정하지 않고, 선택된 구간의 평균을 다음 Replica 계산에 전달합니다.
요청 증가 속도와 CPU 사용률로 계산한 추가 파드 수
요청이 같은 속도로 늘어도 현재 CPU 사용률에 따라 필요한 파드 수는 달라집니다. 평균 증가 속도와 CPU 사용률을 함께 사용해 증가 추세와 현재 부하를 반영했습니다.
현재 CPU 사용률과 평균 증가 속도로 부하가 100%에 도달할 때까지의 여유를 판단했습니다. 원문에서는 이를 기본 안정화 구간의 두 배인 10분 범위에서 확인합니다. 같은 증가 속도라도 CPU가 이미 높으면 더 일찍 추가 파드가 필요하므로, 요청 추세와 현재 부하를 함께 사용했습니다.
p-HPA는 급증을 감지한 경우에만 파드를 먼저 추가합니다. 그 외에는 기존 HPA가 파드 수를 조정하도록 두어, 선제적 확장 기능을 기존 제어에 덧붙였습니다.
세 부하 패턴과 세 Threshold를 조합한 실험
Intel Xeon Cascade Lake(4 vCPU, 16GB) 기반 클러스터에서 CPU 집약적인 PHP 행렬곱 서비스를 실행했습니다. 선형, 주기형(sinusoidal), 지수형 부하로 분당 0~2,000건의 요청을 보내고, CPU Threshold 70%, 80%, 90%에서 기본 HPA와 비교했습니다.
선형 부하는 꾸준한 증가, 주기형 부하는 반복적인 증가와 감소, 지수형 부하는 가속되는 증가를 평가하는 조건입니다. 각 패턴에서 Threshold 70%, 80%, 90%를 따로 적용해 기본 HPA의 설정에 따라 선제적 확장의 효과가 달라지는지도 살폈습니다.
평가에서는 P95와 tail latency를 함께 비교하고, 더 이른 파드 생성에 필요한 평균 자원 사용량도 확인했습니다. 부하 패턴과 Threshold를 동일하게 둔 두 방식의 차이를 비교해 지연 개선과 자원 증가를 함께 해석했습니다.
세 가지 시나리오에서 줄어든 지연과 약 13% 늘어난 자원 사용
실험한 모든 부하와 Threshold 조합에서 tail latency와 P95가 낮아졌습니다. Threshold 90%의 지수형 부하에서는 tail latency가 HPA의 1,106.6ms에서 p-HPA의 879.8ms로 줄었습니다. 아래 표는 보관 원문의 측정값을 같은 Threshold 조건으로 비교한 것입니다.
평균 자원 사용은 HPA보다 약 13% 많았습니다. 파드를 더 일찍 준비해 지연을 줄인 데 따른 자원 사용 증가입니다. 검증 범위는 선형, 주기형, 지수형으로 만든 CPU 집약 부하이며, 다른 병목을 가진 서비스에는 추가 실험이 필요합니다.
제가 제1저자로 수행한 연구입니다. 후속 과제로 제시한 ARIMA 기반 시계열 예측과 Threshold 자동 조정은 이후 Online ARIMA와 adaptive Threshold를 적용한 LARE-HPA로 이어졌습니다.
| 부하 | HPA (ms) | p-HPA (ms) |
|---|---|---|
| 선형 | 2,504.2 | 2,332.6 |
| 주기형 | 2,497.0 | 2,360.8 |
| 지수형 | 1,106.6 | 879.8 |