Optimizing Traffic Allocation for Multi-replica Microservice Deployments in Edge Cloud
22nd International Conference on Service-Oriented Computing
- SCIE-compatible Top-tier
파드를 가까이 배치하는 것만으로는 느린 요청을 줄이기 어려웠습니다. 배치 단계에서 통신 거리를 줄이고, 실행 중에는 부하 균형을 지키는 범위에서 경로별 요청 비율을 계산했습니다.
- 역할
- 제3저자 · 알고리즘 및 실험 설계 기여
- 핵심 결과
- DAG의 고지연 Scenario B에서 기본 Kubernetes 대비 P99 67~81% 감소. 기본 배치에 LATA만 적용한 비교도 수행.
Replica가 늘어나면 통신 경로도 달라집니다
호출하는 컴포넌트와 호출받는 컴포넌트에 파드가 각각 A개와 B개 있으면 통신 경로는 A×B개로 늘어납니다. 파드가 놓인 노드에 따라 각 경로의 지연도 다릅니다. 컴포넌트당 파드 하나를 가정한 배치만으로는 이 경로들의 비용 차이까지 반영하기 어려웠습니다.
멀리 떨어진 노드 사이로 요청을 보내면 통신 지연이 늘지만, 가까운 파드에만 몰아주면 과부하가 생깁니다. 실험에서 노드 간 지연을 2배로 늘리자 기본 방식의 평균 응답시간은 33~44%, P99는 57~97% 증가했습니다. 반대로 가장 가까운 파드에만 요청을 보내자 100→300 RPS 구간에서 평균 응답시간이 11ms→4,890ms, P99가 22ms→12,250ms로 증가했습니다.
OptTraffic은 같은 노드의 파드에 먼저 요청을 보내고, 남은 요청을 다른 노드에 나눠 부하를 맞춥니다. 하지만 이 과정에서도 가장 느린 통신 경로는 남았습니다. 비교 실험에서 평균 응답시간은 35% 줄었지만 P99 개선은 6%에 그쳐, 분배 비율을 정할 때 경로별 지연을 반영하고자 했습니다.
배치와 요청 분배를 함께 다뤘습니다
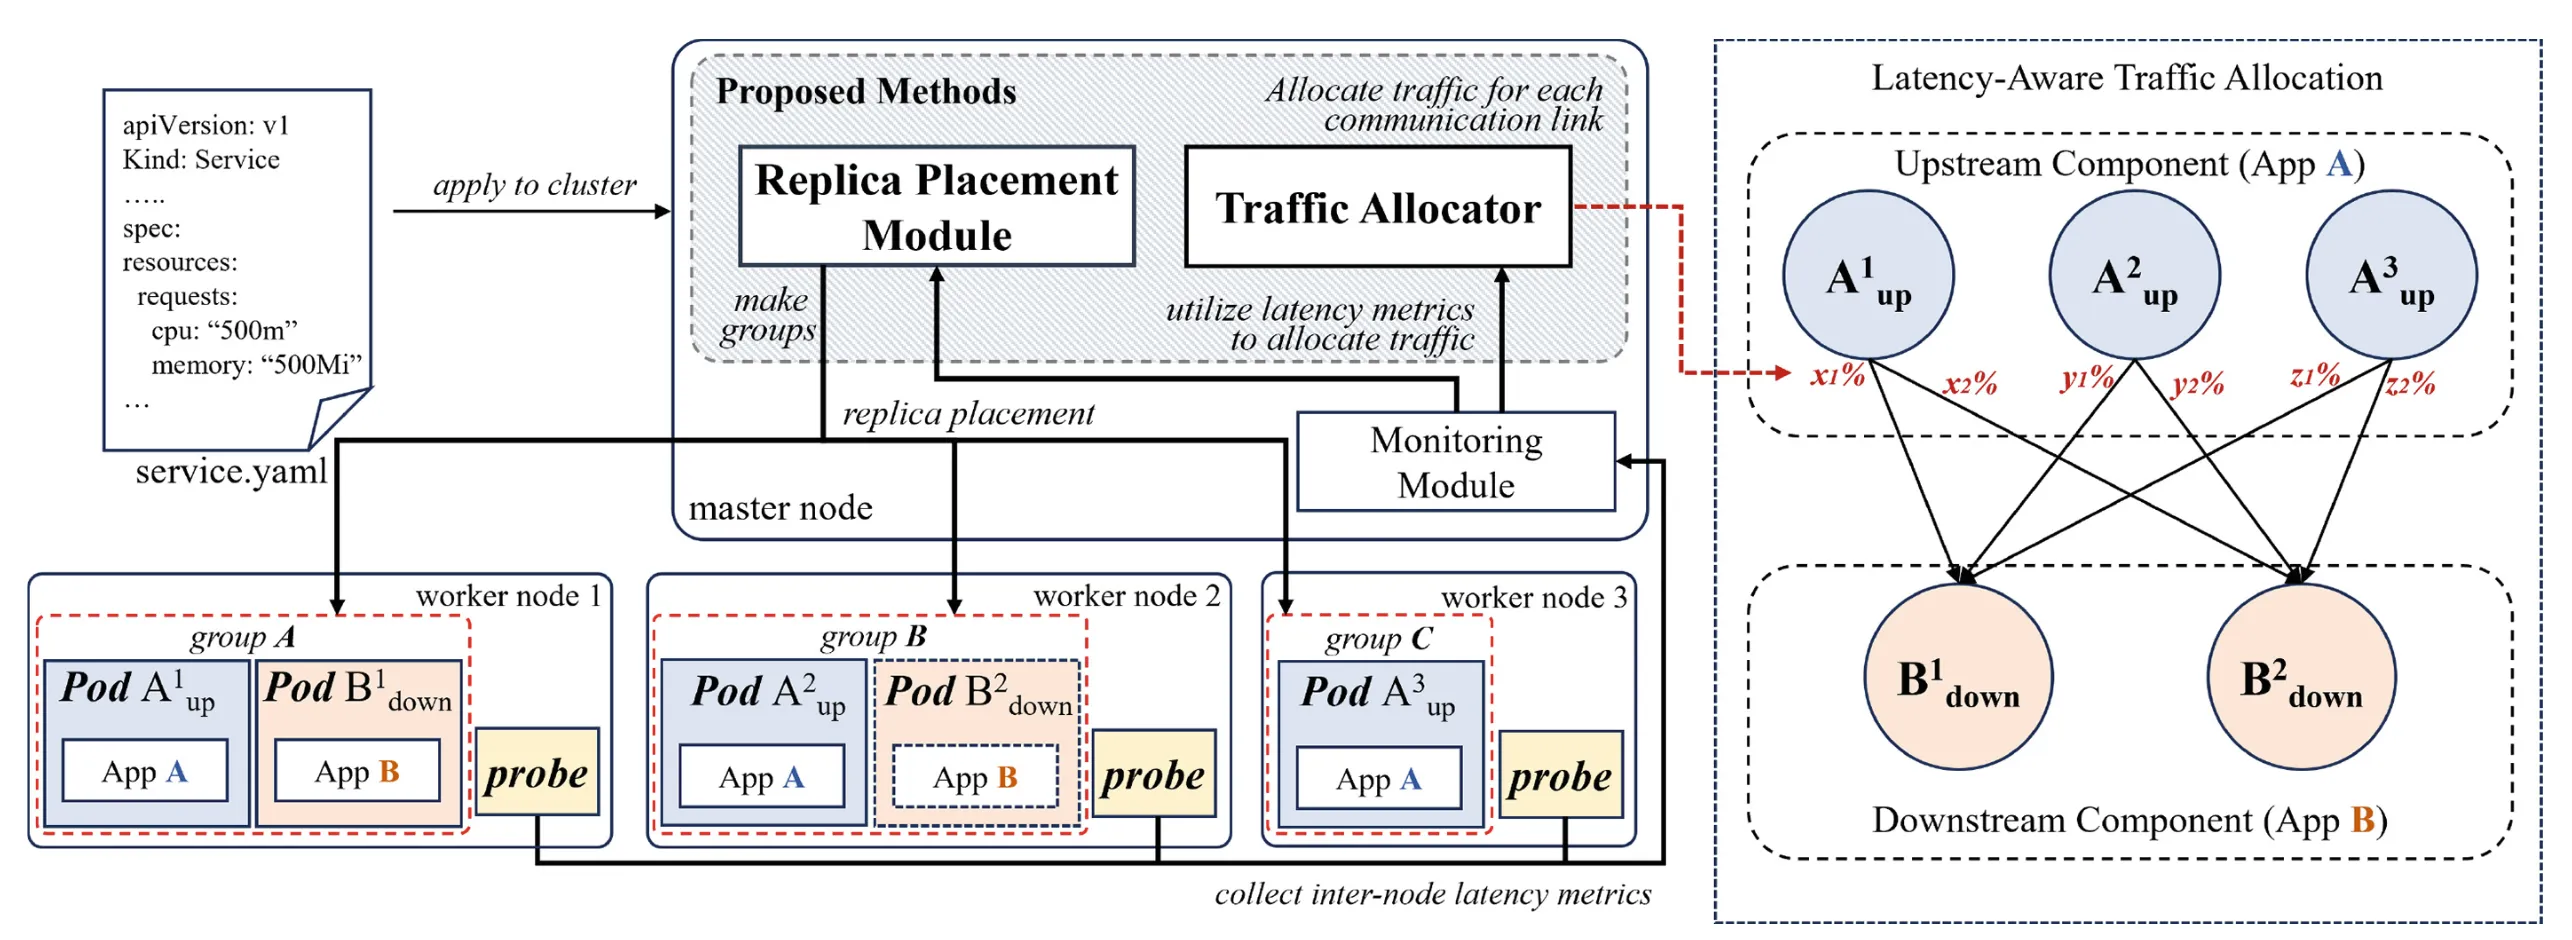
먼저 LARP로 서로 통신하는 파드를 가까운 노드에 배치했습니다. 실행 중에는 LATA가 링크별 요청 비율을 계산해, 통신 지연을 줄이면서 특정 파드에 부하가 몰리지 않도록 했습니다. 배치와 요청 분배를 각각 조정하는 두 단계로 구성했습니다.
blackbox-exporter의 ping 측정으로 노드 간 지연을 수집하고 Prometheus에 저장했습니다. 요청 분배기는 Istio에서 컴포넌트의 호출 관계를 DAG로 구성한 뒤, 호출하는 쪽과 호출받는 쪽의 쌍마다 비율을 계산합니다.
LARP · 자원이 충분하고 가까운 노드에 배치했습니다
컴포넌트별 평균 Replica 수를 기준으로 그룹을 만들고 파드를 차례로 나눠 담았습니다. A가 3개, B가 2개라면 그룹 2개를 만듭니다. 서로 호출하는 파드를 같은 그룹으로 묶어 노드 간 통신을 줄이되, 그룹은 여러 노드에 분산해 한 노드에 모든 파드가 몰리지 않도록 했습니다.
그룹이 배치될 노드 사이의 총지연을 줄이는 정수계획 문제로 정의했습니다. 모든 배치를 탐색하는 대신 자원 요구량이 큰 그룹부터 배치하고, 나머지를 자원이 충분하면서 앞서 선택한 노드와 지연이 작은 곳에 배치하는 탐욕적 근사를 적용했습니다. 최적해를 보장하기보다 실행 가능한 시간 안에 배치를 구하는 쪽을 택했습니다.
LATA · 통신 지연을 최소 비용 흐름 문제로 풀었습니다
배치가 끝나면 각 링크에 얼마나 많은 요청을 보낼지 정해야 합니다. 호출하는 파드를 공급 정점, 호출받는 파드를 수요 정점으로 놓고, 링크마다 용량과 비용을 부여한 최소 비용 흐름(MCF) 문제로 구성했습니다.
링크의 비용은 실제 측정한 노드 간 지연으로 정했습니다. 같은 양의 요청이라도 느린 링크를 이용하면 비용이 커지도록 한 것입니다. network simplex로 트래픽 양과 지연시간을 곱한 합이 가장 작은 분배 비율을 구했습니다.
부하 균형을 최적화의 제약조건에 넣었습니다
부하를 나중에 보정하면 느린 경로를 다시 사용해야 할 수 있습니다. LATA는 각 송신 파드가 요청의 100%를 전달하고, 수신 파드는 정해진 균등 비율을 받도록 제약조건을 뒀습니다. 이 조건을 지키는 분배 중 통신 비용이 가장 작은 해를 선택했습니다.
실험과 결과
Master 1대와 worker 4대(각 4-core·8GB)로 cluster를 구성하고, Linux tc로 inter-node latency를 두 scenario(A, B=A의 2배)로 설정해 지리적으로 분산된 edge cloud를 모사했습니다. Istio Bookinfo와 A→E를 순차 호출하는 FastAPI 기반 DAG, 두 benchmark에서 component마다 3~5개 replica를 두고 wrk2로 부하를 인가하며 10회 평균을 기본 K8s·Localization·OptTraffic과 비교했습니다.
비교군이 불리한 배치에서만 효과가 나는지 확인하기 위해, OptTraffic이 통신을 줄이기 좋은 Replica 비율을 실험 조건으로 잡았습니다. 모든 요청 구간에서 제안 기법이 앞선 것은 아닙니다. DAG Scenario B의 하위 65% 구간에서는 OptTraffic이 더 빨랐지만, 느린 요청이 몰린 꼬리 구간과 평균 응답시간은 제안 기법이 개선했습니다.
제안 기법은 세 baseline 대비 P99 tail latency를 평균 32%, 최대 81% 낮췄습니다. latency가 큰 Bookinfo scenario B에서 OptTraffic 대비 P99를 평균 25% 줄였고, topology가 복잡한 DAG scenario B에서는 P99를 Localization 대비 48~72%, OptTraffic 대비 43~46%, 기본 K8s 대비 67~81% 낮췄습니다. 특히 기본 K8s placement에 LATA만 적용해도 두 번째로 우수한 성능을 보여, allocation stage가 placement와 독립적으로 기여함을 확인했습니다. 본 논문은 SCIE급 최상위 학회 ICSOC 2024(LNCS 15404)에 게재됐으며, 저는 제3저자로 algorithm 및 실험 설계에 기여했습니다. 이 placement·allocation 접근은 이후 heterogeneous cluster로 확장한 HEART(IEEE CLOUD 2025)로 이어졌습니다.
| 실험 조건 | 비교군 | P99 감소 |
|---|---|---|
| Bookinfo · Scenario B | OptTraffic | 평균 25% |
| DAG · Scenario B | Localization | 48~72% |
| DAG · Scenario B | OptTraffic | 43~46% |
| DAG · Scenario B | 기본 Kubernetes | 67~81% |