E2E QA Automation
Google Sheets·Jira 연동 이후에도 남아 있던 반복 검수를 줄이기 위해 E2E 인프라를 처음부터 설계·구축했습니다. 기본 업무 흐름을 자동 검증하고, 테스트 서버 배포 전에도 실행할 수 있도록 PR별 k3s 격리 환경을 구축했습니다.
1인 QA 평균 약 3일 · 검증 티켓 24% 증가 · E2E 약 1시간
반복되는 기본 기능 검수에 묶여 있던 QA
입사 초반에는 저를 포함한 PO 3명이 기능 검수를 나누어 맡았습니다. 하나의 릴리즈 버전마다 QA에만 보통 1주, 길게는 2주가 걸렸습니다. 무엇을 확인해야 하는지 정하는 일부터 사람의 기억과 경험에 의존했고, 로그인·조회·등록·수정 같은 기본 동작을 매번 손으로 확인하는 데 많은 시간이 들었습니다.
하나의 기능이 바뀌더라도 다른 기능과 업무에 미치는 영향 범위는 제각각이었습니다. 검수에 많은 시간을 들여도 그 영향을 모두 확인하기 어려웠고, 배포 후 긴급 패치도 잦았습니다. 같은 기본 검사를 반복하는 동안 변경된 기능의 예외와 회귀를 더 살펴볼 시간이 부족해지는 구조를 바꿀 필요가 있었습니다.
Google Sheets에서 작성하고 Jira까지 이어지는 QA 기록 관리
처음에는 업무를 하나로 관리하기 위해 검수 기록을 연결하는 작업을 수행했습니다. TC를 작성하고 관리하던 Google Sheets에서 Google Apps Script로 Jira API를 호출해, 버그를 등록하면 Jira 이슈가 생성되도록 연동했습니다.
이전에는 QA 중 버그가 발생하면 어떤 기능을 검수했고, 어느 화면에서 어떤 결과가 나왔으며(AS-IS), 어떤 결과가 나와야 했는지(TO-BE)를 매번 Jira에 수기로 작성해야 했습니다. 이 내용을 Google Sheets에서 작성해 Jira 티켓으로 전달하도록 바꾸면서, 두 도구를 반복해서 오가며 같은 내용을 다시 적는 비효율을 줄였습니다. 티켓 상태는 Jira API로 실시간 폴링해 시트에 동기화하고, 내용 요약도 함께 확인할 수 있게 했습니다. 개발자가 대응 중인 티켓의 진행 상태까지 Google Sheets 한 곳에서 관리하기 쉬워졌습니다.
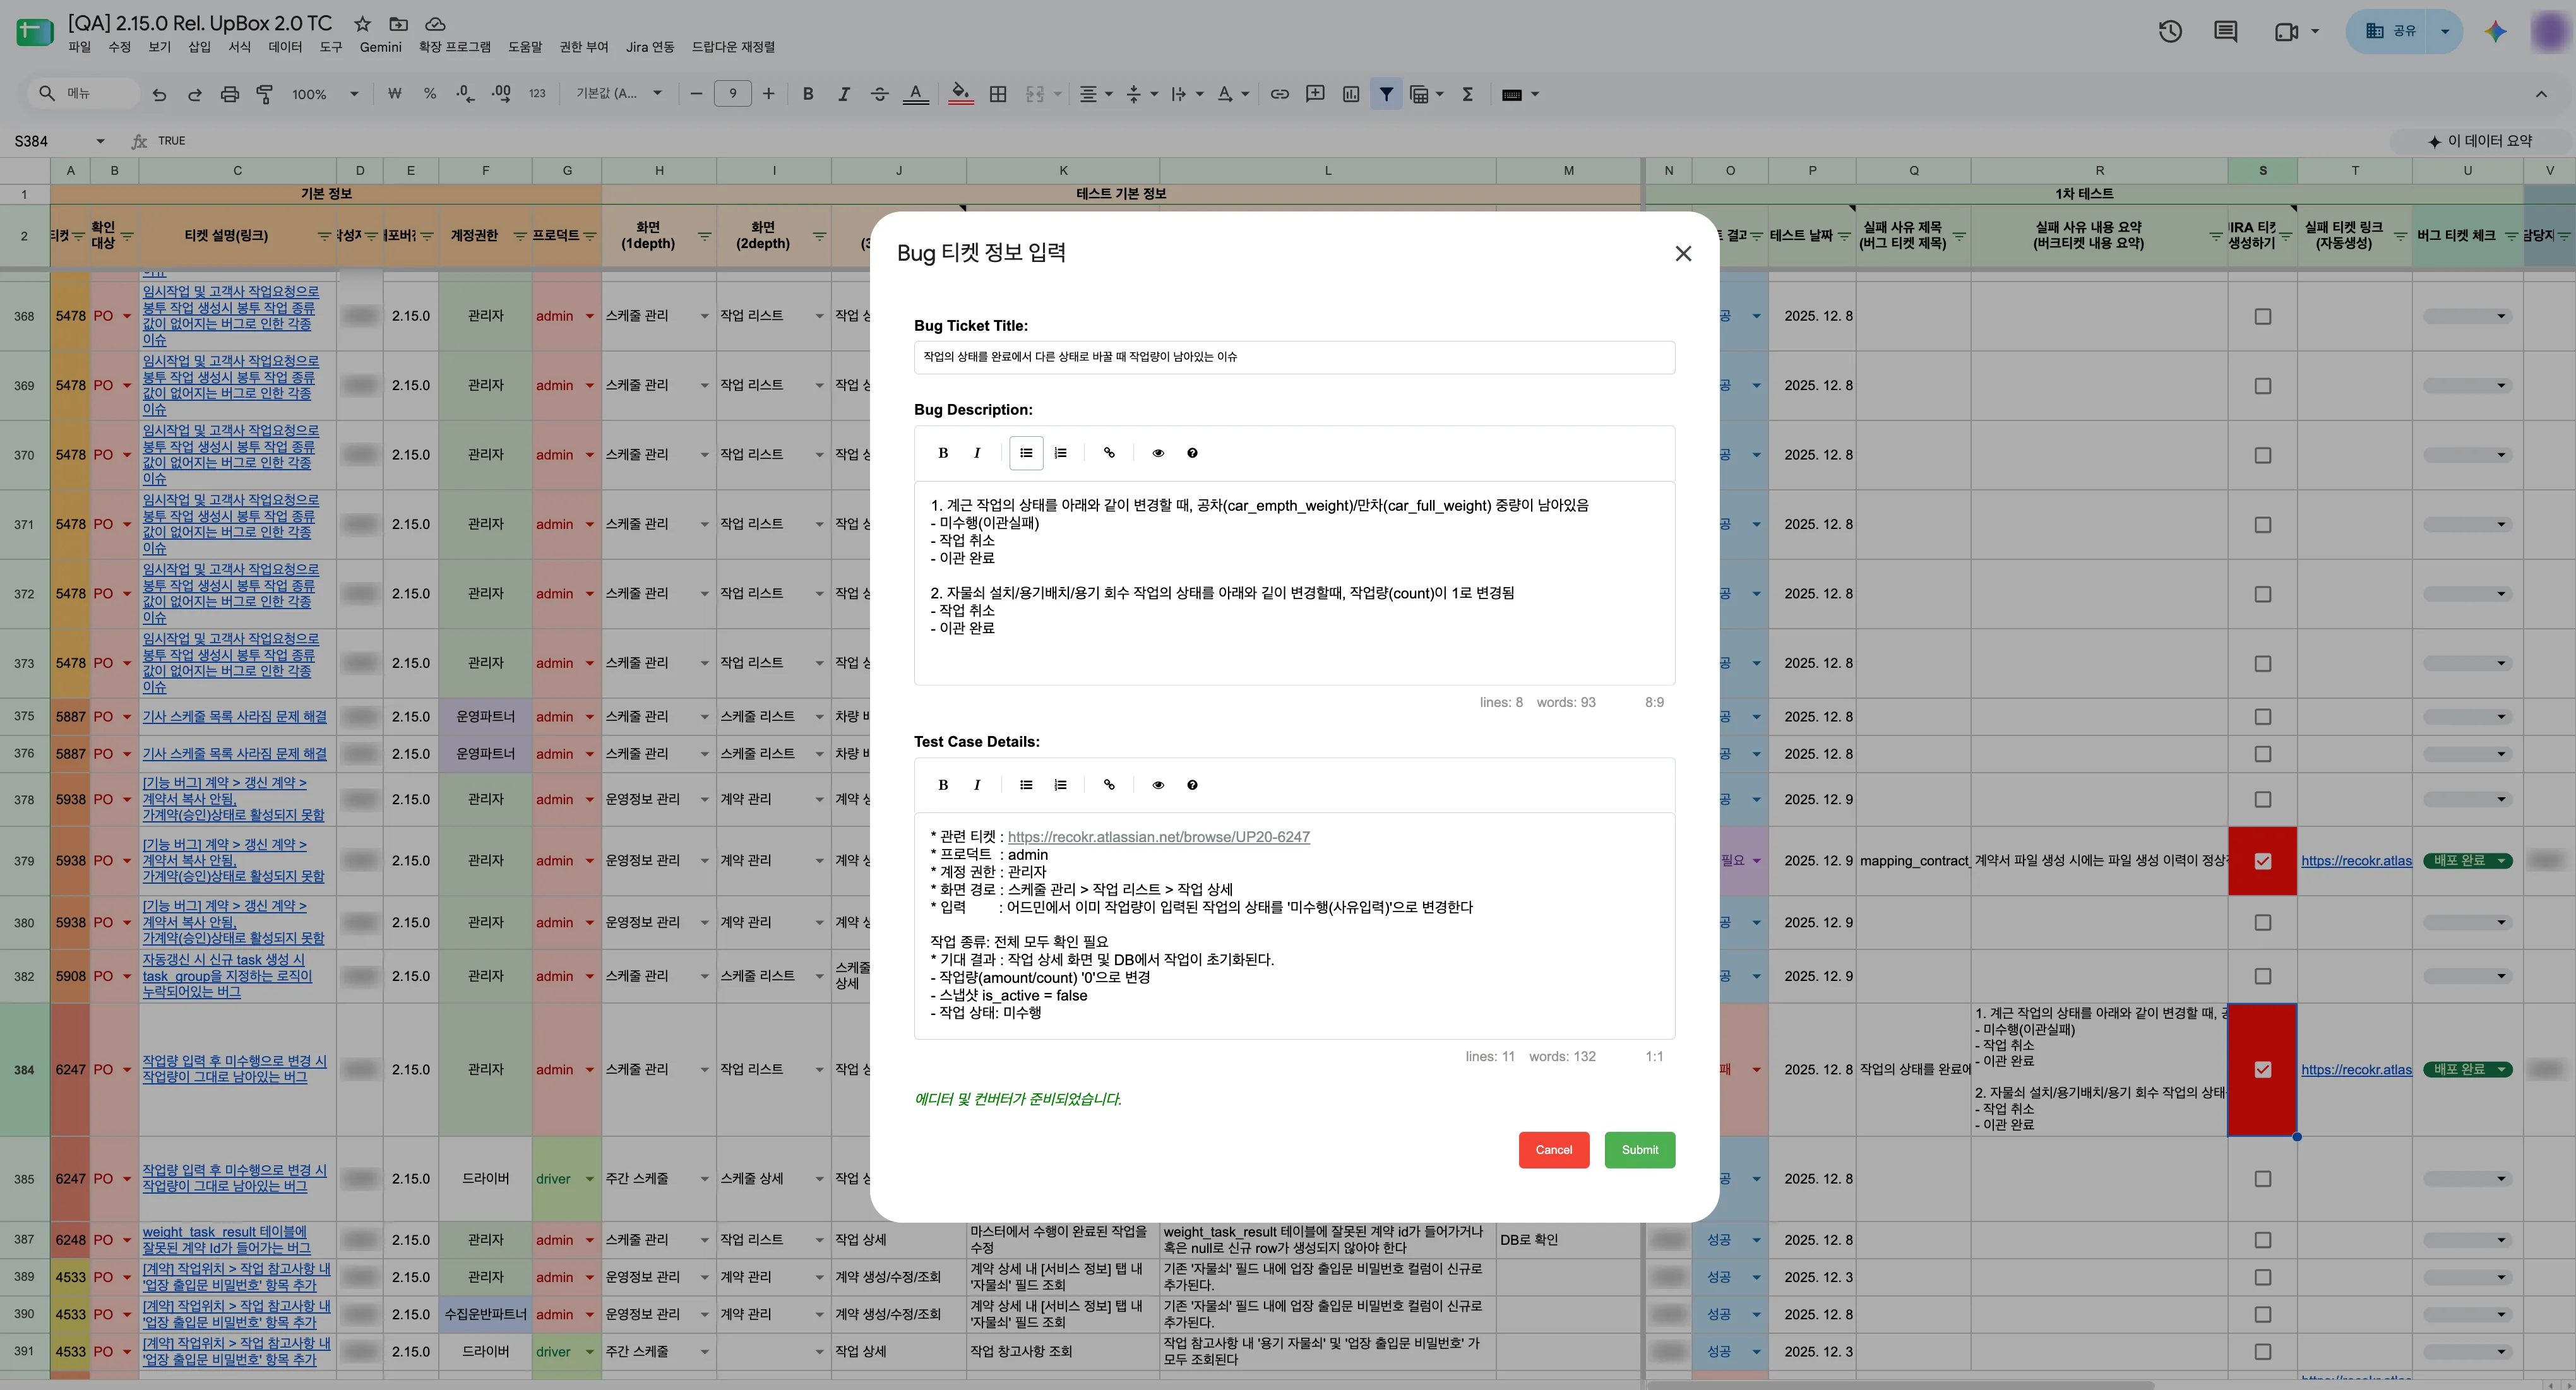
검수 대상과 버그 수정 상태를 한곳에서 관리할 수 있게 됐지만, 다음 배포에서도 같은 화면을 다시 눌러야 했습니다. 도구 연동으로 중복 업무는 줄였어도 기본 기능을 검증하는 데 드는 시간은 해결하지 못했습니다. 이 작업을 계속 사람이 맡는 한, 새 기능의 정책과 예외를 더 살펴볼 시간을 확보하기 어려웠습니다.
반복적인 QA 자동화를 위한 E2E 테스트 인프라 0→1 구축
이 한계를 해결하기 위해, 반복되는 기본 검증을 코드로 남겨 실행하는 E2E 인프라 구축을 제가 직접 시작했습니다. 먼저 로그인·저장·조회와 계약·스케줄·수거처럼 업무에 꼭 필요한 흐름을 자동화 범위로 정했습니다. 새로운 정책과 예외를 판단하는 검수는 사람이 맡고, 이미 동작해야 하는 기능을 매번 확인하는 일부터 자동화에 맡기기로 했습니다.
기존에 이어받을 자동화 기반이 없어 실행 구조부터 설계했습니다. Playwright·TypeScript로 로그인, 화면 이동, 입력, 테스트 데이터 생성·정리에 필요한 공통 코드를 만들고, 시나리오의 실행 순서와 실패 처리, CI 실행과 결과 공유까지 연결했습니다. 테스트를 작성하는 데서 끝내지 않고 다음 검수에서도 다시 실행할 수 있는 기반을 구축했습니다.
각기 다른 플랫폼의 사용자 업무를 하나의 E2E 검증 흐름으로 통합
Admin에서 계약·스케줄·작업요청을 만들고, Driver 앱에서 배정된 수거를 수행한 뒤, 다시 Admin에서 이력과 결과를 확인합니다. 화면별 테스트를 따로 통과시키는 것보다 앞 화면에서 만든 데이터가 다음 업무까지 올바르게 이어지는지 확인하는 것이 중요했습니다.
검증 대상인 Admin·Customer·Driver는 로그인 상태를 역할별로 분리해 재사용합니다. 이 중 Admin과 Driver를 오가는 업무는 Playwright의 프로젝트 의존성과 teardown으로 준비·수행·검증·정리 순서를 연결했습니다. Driver 검증이 시급해졌을 때도 별도의 화면 검사에 그치지 않고 Admin에서 만든 데이터가 실제 현장 수행까지 이어지는지 확인하도록 범위를 넓혔습니다.
매번 같은 조건에서 다시 돌릴 수 있는 E2E 실행 환경
테스트 서버에 필요한 계약이나 스케줄이 이미 있을 것이라고 가정하면 데이터가 바뀔 때마다 검증이 깨집니다. 실행 중 필요한 업무 데이터를 직접 만들고, 단계 사이에서 식별자를 전달하도록 했습니다. 공유 파일의 쓰기 충돌은 뮤텍스로 제어하고, 정상 정리와 실패 시 fallback 정리를 별도로 두어 다음 실행에 남는 데이터를 줄였습니다.
화면에서 성공 알림이 보이는 것만으로는 충분하지 않아 저장된 상태와 금액은 API로도 대조했습니다. 검증 범위는 TC뿐 아니라 Jira의 과거 버그, 코드 변경, 연결된 업무를 보고 정했습니다. 최근에는 직접 구현한 RAG로 이 근거를 모으고, 제가 내용을 확인해 역할·상태·예외·회귀 케이스를 구성합니다. 반복 검증할 케이스는 테스트 코드로 구현해 CI에서 실행하고, 자동화 밖의 정책 판단과 복잡한 조합은 브라우저 QA로 보완합니다.
PR별 k3s 격리 환경 기반 사전 E2E 검증으로 자동화 범위 확대
테스트 서버에 배포하기 전에 작은 기능 단위의 PR에서 기본 동작을 먼저 확인할 수 있도록 E2E 검증을 확장했습니다. 개발자가 작업한 기능의 검증 결과를 PR에서 확인하고, 문제가 있으면 배포 전에 수정할 수 있게 했습니다.
PR 요청 → 환경 준비 → E2E 실행 → 결과 확인
-
PR 요청 및 테스트할 코드 확인
-
앱 빌드 및 테스트 이미지 준비
-
PR별 k3s 테스트 환경 배포
-
Playwright로 E2E 테스트 실행
-
PR에 결과 공유 및 테스트 환경 정리
PR의 코드를 테스트 서버에 배포하지 않고 검증하려면, 해당 코드를 실행할 앱과 DB가 별도로 필요했습니다. 사내 Xeon 서버의 k3s에 Frontend·Backend·DB를 컨테이너로 배포하고, 기존 Helm 차트로 검증 환경을 생성하도록 구성했습니다.
브랜치 이름만 넘기면 빌드 도중 새 커밋이 들어와 실제 검증한 코드가 달라질 수 있습니다. Front는 PR의 정확한 SHA를 확인하고, Backend도 사용할 버전을 결정한 뒤 커밋으로 고정했습니다. 이미지와 DB 스냅샷에는 실행별 태그를 붙여 결과가 어느 코드·데이터 조합에서 나왔는지 추적하도록 했습니다.
각 실행은 별도 namespace로 구분하고 독립된 DB를 사용하도록 했습니다. Playwright는 테스트 서버가 아니라 해당 PR의 앱에 접속해 검증하도록 연결했습니다. 런타임 설정은 Secret으로 전달하고, 외부 fork나 오래된 PR 요청은 셀프 호스티드 러너에 넘기기 전에 차단했습니다.
실패 원인까지 다시 볼 수 있는 테스트 리포트와 로그
테스트가 끝나도 결과 리포트와 로그를 복사할 때까지 컨테이너를 유지해야 했습니다. 종료 코드를 파일로 저장하고 리포트 복사를 기다리는 단계를 넣었습니다. 복사가 끝나면 Pod를 정리하고, 복사에 실패한 Pod나 테스트 실패 환경은 원인 분석을 위해 남기도록 했습니다.
기존 CI에서는 플랫폼별 결과를 합쳐 Slack으로 공유했습니다. k3s 환경에서는 HTML·JSON·JUnit 리포트와 테스트·Backend 로그, Pod 상태와 이벤트를 모아 Front PR에 게시하도록 했습니다. 테스트 자체의 실패와 환경 준비 실패를 구분하고, 성공 환경은 삭제하되 실패 환경은 정해진 시간 동안 조사할 수 있도록 유지했습니다.
이미지 빌드부터 격리 환경 배포, 테스트 실행, 리포트 업로드, PR 결과 게시까지 실제 실행으로 확인했습니다. 날짜에 민감한 스케줄 테스트에서는 브라우저와 Backend의 시간대를 맞췄고, 리포트를 준비 중인 상태가 타임아웃으로 처리되지 않도록 보완했습니다.
1인 QA에서도 +31% 늘어난 검증량과 7.0% → 3.9%로 줄어든 배포 후 버그
입사 초반에는 PO 3명이 QA에 보통 1주, 길게는 2주를 썼습니다. 현재는 제가 QA를 전담하며, 배포 전 검증을 평균 약 3일에 진행하고 있습니다.
E2E는 1시간 내외로 실행되며 계약·스케줄·Driver 수행 같은 기본 흐름을 먼저 확인합니다. 그만큼 매번 같은 화면을 누르는 일을 줄이고, 저는 새로 바뀐 기능의 정책과 예외, 연관 업무에 미치는 영향을 검증하는 데 시간을 쓸 수 있게 됐습니다. Google Sheets·Jira 연동으로 발견한 버그와 수정 상태를 추적하고, 수정 후 재확인까지 이어갑니다.
검증해야 할 기능은 오히려 늘었습니다. E2E 자동화 전(2.13.0~2.14.2)과 후(2.15.0~2.16.1)의 정규 배포를 비교하면, 검증 티켓은 712건에서 992건으로 39% 늘었습니다. E2E 후 구간의 QA는 대부분 제가 전담했습니다.
핫픽스를 제외한 티켓 수를 실제 QA 일수로 나눈 하루 평균 검증량은 22.3건에서 29.2건으로 약 31% 늘었습니다. 같은 QA 기간에 더 많은 기능을 확인할 수 있게 됐다는 뜻입니다.
처리량이 늘어나는 동안 배포 후 버그 비율도 7.0%에서 3.9%로 낮아졌습니다. 기본 회귀는 E2E로 반복 확인하고, 자동화 밖의 기능·예외 검수와 Jira 후속 추적은 직접 맡는 방식으로 QA를 운영했습니다. 다른 PO가 반복 검수에 함께 투입되던 부담을 줄이면서, 더 많은 기능을 검증할 수 있게 됐습니다.
| 업무 지표 | E2E 전 | E2E 후 |
|---|---|---|
| 검증 티켓 | 712건 | 992건 · 39% 증가 |
| 하루 평균 검증량 · 티켓/일 | 22.3건/일 | 29.2건/일 · 약 31% 증가 |
| 배포 후 버그 비율 | 7.0% · 50건 / 712건 | 3.9% · 39건 / 992건 |
기본 검증은 코드에, 사람은 새 기능과 예외에 집중하는 QA
엑셀에 검수 항목을 적던 일에서 출발해, 기록을 연결하고 기본 동작을 자동화한 뒤 실행 환경까지 직접 구축했습니다. QA를 혼자 담당하면서도 더 많은 기능을 확인할 수 있게 된 것은, 반복 검사를 코드로 남기고 새 기능과 예외에 집중할 시간을 확보했기 때문입니다. PR별 k3s 격리 환경도 구축해 테스트 서버에 배포하기 전부터 기본 기능을 검증하고, 개발자가 PR에서 결과와 실패 원인을 확인할 수 있도록 했습니다.