LARE-HPA
Summary
워크로드에 따라 Threshold와 Cool Down Time을 스스로 조정하는 Kubernetes 오토스케일러입니다. 사전 학습 없이 온라인으로 동작하며, trade-off 관계에 있는 지연시간과 자원 효율을 함께 최적화합니다. 요청의 변동이 클수록 Threshold를 낮추고, 요청 추세에 맞춰 Cool Down Time을 조정합니다. 어떤 애플리케이션에도 독립적으로 스케일링을 적용할 수 있습니다.
- Role
- First AuthorDeveloper
- Outcome
- 평균 지연 50.34%↓ vs HPAICSOC Distinguished
들어가며
"scaling threshold 값을 몇 %로 잡아야 할까?" 오토스케일링에서는 한 가지 정답이 없어 운영자의 경험에 의존해 Threshold를 설정해 왔습니다. 시스템이 부하 변화에 스스로 적응하며 이 값을 자동으로 조정할 수 없을까라는 질문에서 출발했습니다.
정적인 threshold에서는 부하에 따라 응답 레이턴시와 리소스 사용량이 달라집니다. 요청의 변동성에 따라 scaling threshold를, 추세에 따라 scale-in 쿨 다운 타임을 조정하는 컨트롤러를 구현했습니다.
알고리즘 유도와 실험 상세는 Publications의 LARE-HPA 논문에 있습니다.
고정 설정만으로는 부하 변화에 대응하기 어려웠습니다
HPA의 threshold를 낮게 설정하면 더 일찍 확장되지만, 리소스 사용량도 늘어납니다. 논문 실험에서는 threshold를 60%로 설정했을 때 90%보다 CPU 할당량이 약 22% 많았습니다. 반대로 threshold를 높이면 확장이 늦어져 응답 레이턴시가 늘어날 수 있습니다. 응답 레이턴시와 리소스 사용량을 함께 고려하려면 부하 변화에 맞춰 threshold를 조정할 필요가 있었습니다.
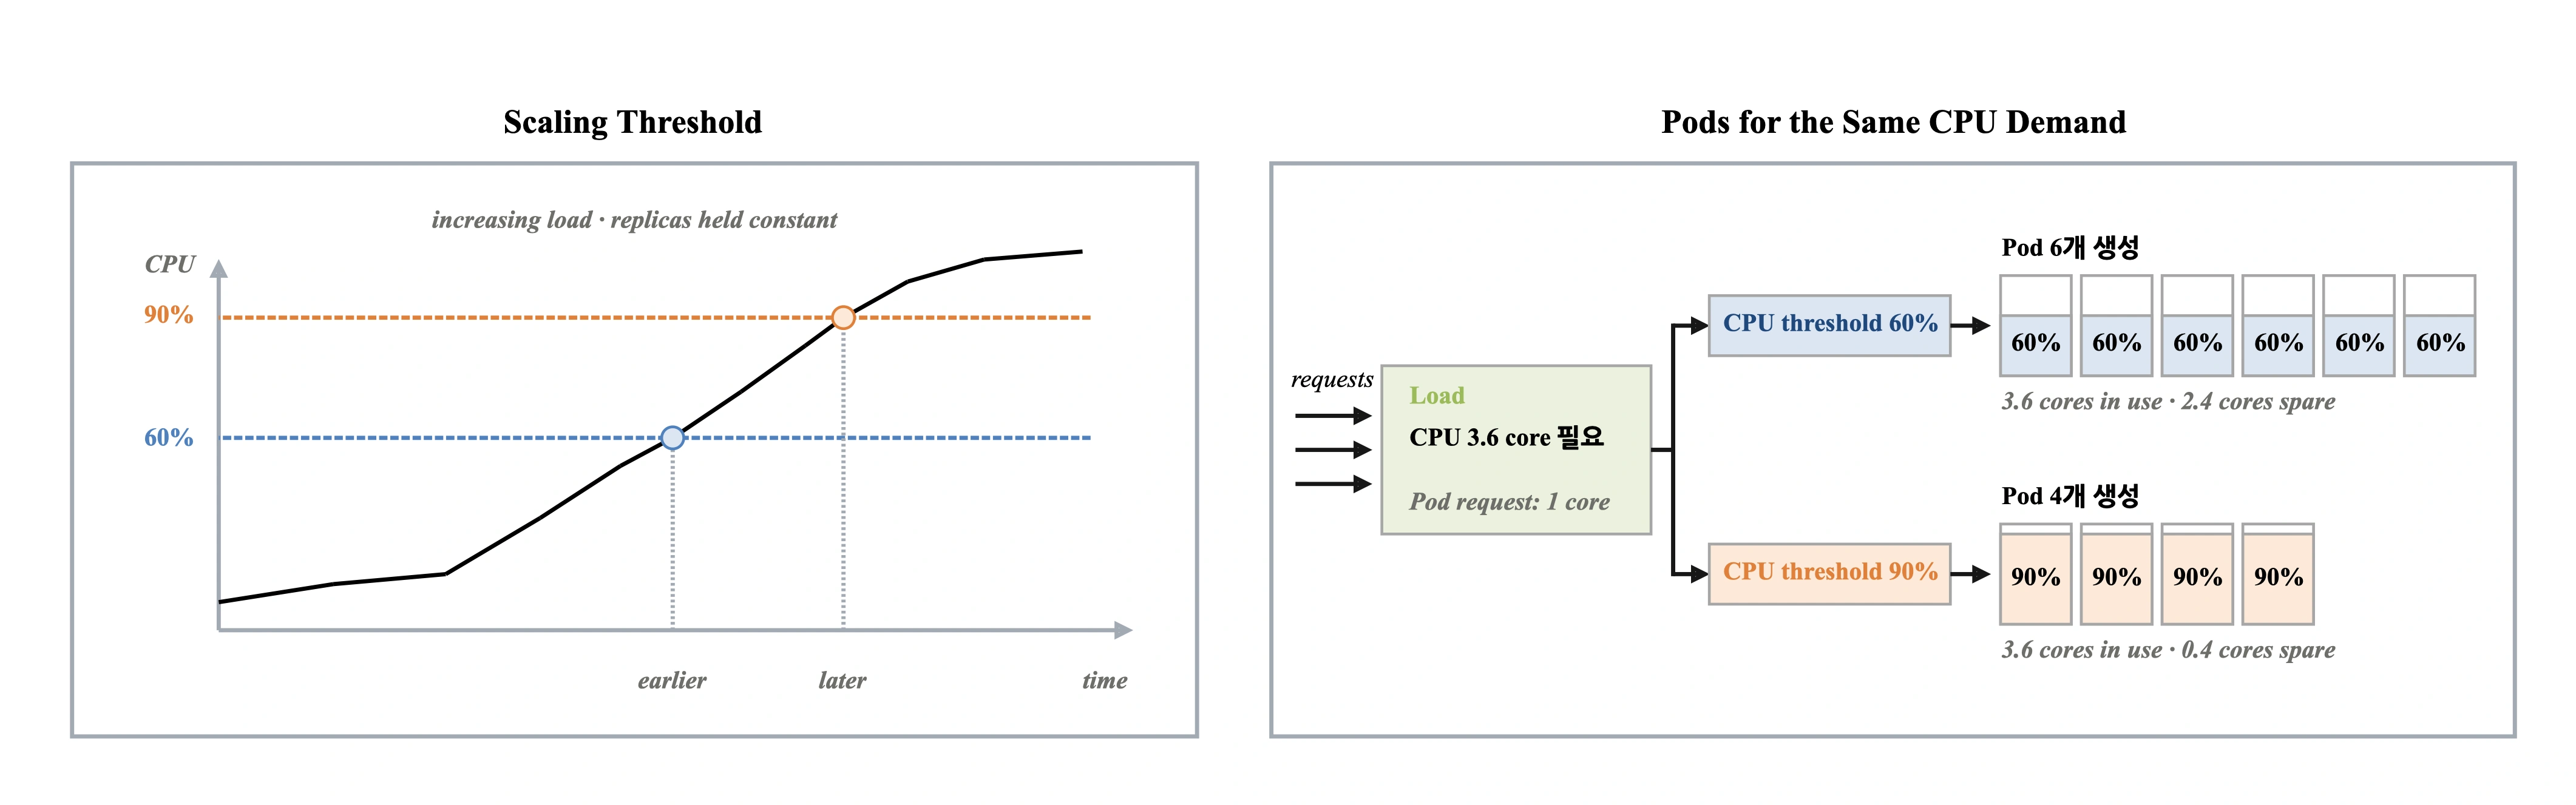
Pod를 줄인 직후 요청이 다시 늘어나면 scale-in과 scale-out이 반복되는 flapping 현상이 발생합니다. 이를 해결하기 위해 단순히 쿨 다운 타임을 길게 설정하면 부하가 줄어든 뒤에도 필요 이상의 Pod를 유지하게 됩니다. 따라서 threshold뿐 아니라 요청의 추세에 따라 쿨 다운 타임도 조정할 필요가 있었습니다.
AI 모델을 사용하여 부하를 예측해 대응하는 방법도 있지만, 신규 애플리케이션에는 사전 학습에 필요한 데이터가 부족했습니다. 요청 패턴이 바뀔 때마다 모델을 다시 학습해야 하는 부담도 있어, 실행 중 수집한 데이터로 모델을 계속 갱신하는 방식을 선택했습니다.
LARE-HPA는 온라인으로 부하를 예측하고, 요청의 변동성에 따라 threshold를, 추세에 따라 쿨 다운 타임을 조정합니다. 사전 학습 데이터를 따로 준비하지 않고 실행 중 수집한 데이터를 사용합니다.
하나의 Pod, 3개의 핵심 프로세스
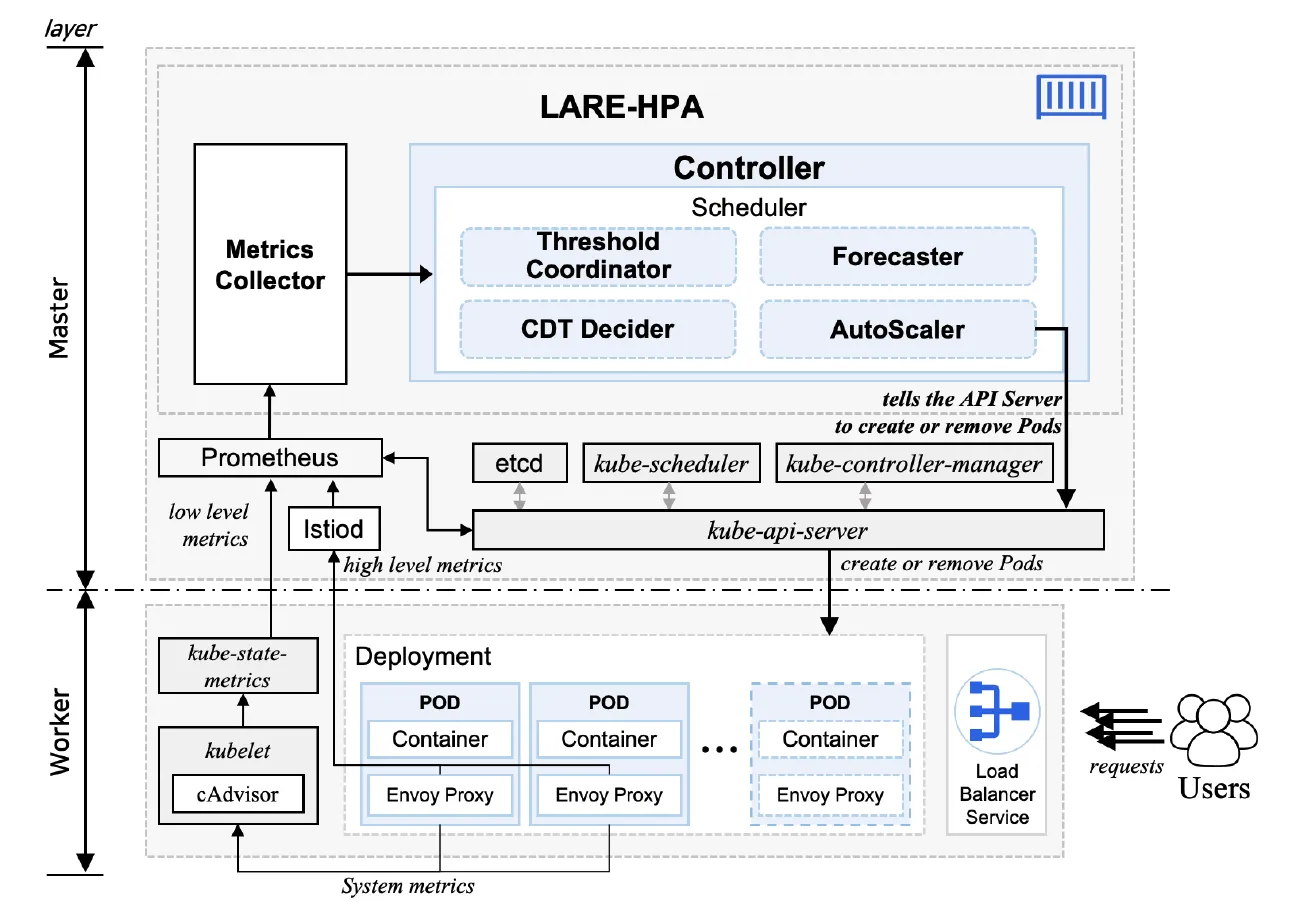
부하 변화에 맞춰 threshold와 쿨 다운 타임을 계속 갱신하고, 그 결과를 실제 Pod 수 조정에 반영할 수 있어야 했습니다. 이를 위해 단일 Pod 안에서 멀티 프로세싱을 활용하여 3개의 독립 프로세스가 병렬로 동작하도록 구현했습니다. 각 프로세스는 부하 예측과 threshold 갱신, 요청 추세에 따른 쿨 다운 타임 조정, 실제 스케일링을 나누어 담당합니다. threshold와 쿨 다운 카운터는 공유 메모리로 전달하고, 값을 읽거나 갱신하는 구간에는 Lock을 사용하여 여러 프로세스가 동시에 수정하지 않도록 했습니다. 스케일링 프로세스는 현재 CPU 사용률과 갱신된 threshold로 필요한 Pod 수를 계산하고, scale-in 시에는 쿨 다운 조건을 확인한 뒤 Kubernetes API로 반영합니다.
Metrics Collector는 Prometheus에 수집된 시스템 메트릭과 Istio Envoy의 요청 메트릭을 조회합니다. Forecaster와 Threshold Coordinator는 같은 프로세스에서 부하를 예측하고 threshold를 갱신하며, CDT Decider는 별도의 프로세스에서 요청 추세에 따라 쿨 다운 타임을 조정합니다. AutoScaler는 이 결과를 바탕으로 Kubernetes API를 호출하여 Deployment의 Replica 수를 조정합니다.
예측, threshold, 쿨 다운 타임을 함께 조정했습니다
Forecaster는 온라인 학습 기반 ARIMA를 사용하여 다음 구간의 부하를 예측합니다. 기존 ARIMA는 충분한 데이터를 토대로 오프라인 학습이 필요하지만, 온라인 학습 기반 ARIMA는 요청 데이터가 들어올 때마다 Online Newton-Step으로 자기회귀 계수를 갱신하여, 오프라인 재학습 없이 요청 패턴의 변화를 반영할 수 있다는 장점이 있습니다. 예측에는 최근 10개 시점의 요청 메트릭을 사용하며, 예측한 요청 값이 음수가 될 때는 0으로 처리합니다.
Threshold Coordinator는 예측한 부하와 최근 요청 메트릭을 바탕으로 threshold를 조정합니다. 요청 수에는 정해진 상한이 없지만 threshold는 백분율 범위에서 정해야 하므로, 요청 변화량을 정규화할 필요가 있었습니다. 최근 10개 구간의 요청 변화량을 전체 이력과 비교하여 z-score로 변동성을 계산하고, 역 시그모이드 함수로 50~95% 범위의 threshold로 변환했습니다. 변동성이 낮을 때는 threshold를 높여 불필요한 Pod 확장을 줄이고, 높을 때는 threshold를 낮춰 요청 증가에 더 일찍 대응하도록 했습니다.
CDT Decider는 요청 추세에 따라 쿨 다운 타임을 조정합니다. 최근 60개 시점의 요청 메트릭에 선형회귀를 적용하여 요청이 증가하는지, 감소하는지 확인하고, Durbin-Watson 통계량으로 잔차의 자기상관을 확인합니다. 통계량이 설정한 범위(1.616~2.384)에 들어올 때만 요청 추세를 쿨 다운 타임 조정에 반영합니다. 상승 추세에서는 요청이 일시적으로 줄더라도 Pod를 성급하게 줄이지 않도록 쿨 다운 카운터를 최대 60구간까지 늘립니다. 하강 추세에서는 최소 1구간까지 줄여 불필요한 Pod를 오래 유지하지 않도록 했습니다.
애플리케이션 수정 없이 배포하도록 구성했습니다
LARE-HPA는 python:3.11-slim 이미지 기반 위에 구현되어 컨테이너로 배포됩니다. Kubernetes API로 Replica 수를 조정할 수 있도록 전용 ServiceAccount로 클러스터 내부 인증을 하고, ClusterRole에는 스케일링과 상태 조회에 필요한 권한만 부여했습니다. deployments/scale과 statefulsets/scale에는 patch, get, list, watch 권한을, pods와 services에는 읽기 권한을 설정했습니다.
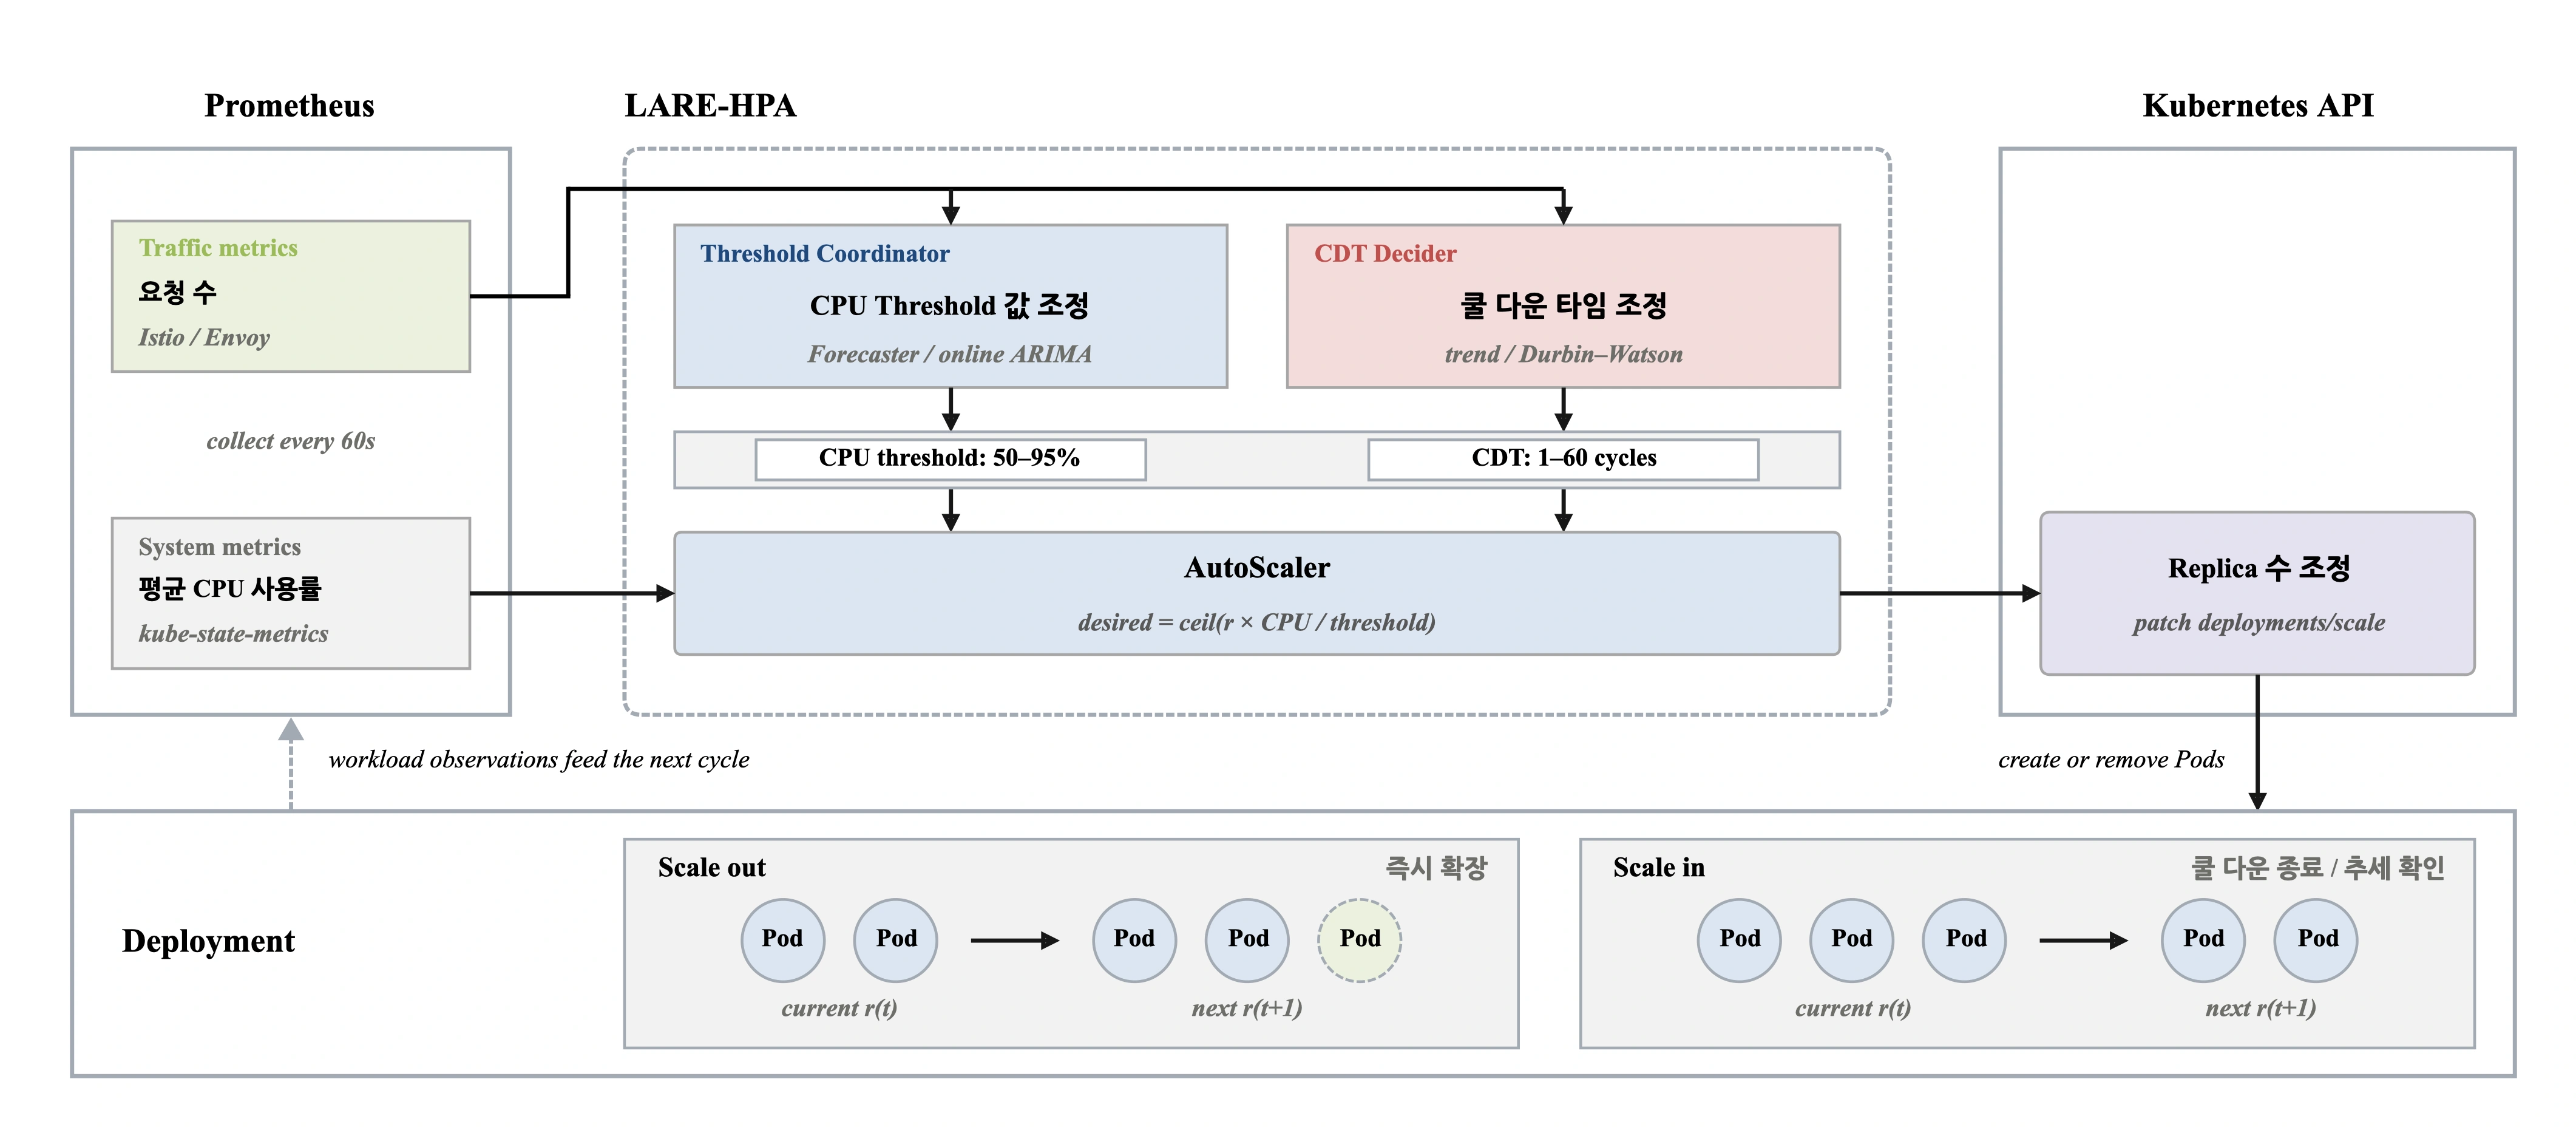
특정 애플리케이션에 종속되지 않고 독립적으로 적용할 수 있도록, 애플리케이션 코드를 수정하지 않고 설정만으로 스케일링 대상을 지정할 수 있게 했습니다. 스케일링을 수행할 애플리케이션, Prometheus 주소, threshold(기본 75%), Replica 범위(1~16), 메트릭 수집 주기(60초)는 ConfigMap으로 설정하며, 스크립트로 컨트롤러를 배포합니다. 예측한 부하와 threshold, 쿨 다운 타임, 오류 로그를 각각 남겨 어떤 메트릭과 설정값으로 Pod 수를 조정했는지 확인할 수 있게 했습니다.
결과
NASA-HTTP의 요청 패턴을 삼각함수를 계산하는 PHP 애플리케이션에 재현하고, 응답 시간 1초를 SLO 기준으로 설정하여 HPA, Bi-LSTM, Online-BO와 비교했습니다. LARE-HPA의 평균 레이턴시는 HPA의 562.8ms에서 279.5ms로 50.34% 감소했고, 95퍼센타일 레이턴시도 1189.0ms에서 600.1ms로 낮아졌습니다. SLO 만족률은 93.86%에서 97.24%로 높아져 네 방식 중 가장 높았습니다. CPU 할당량은 638.13 millicore로 HPA(582.76)보다 약 9.5% 많았지만, Bi-LSTM(875.85)과 Online-BO(1274.75)보다 적었습니다.
| Method | 레이턴시 (ms) | 자원 사용량 (millicore) | SLO 만족률 (%) | ||||
|---|---|---|---|---|---|---|---|
| 평균 | 50th | 75th | 90th | 95th | |||
| HPA | 562.8 | 528.6 | 770.4 | 1001.1 | 1189.0 | 582.76 | 93.86 |
| LARE | 279.5 | 255.5 | 368.1 | 494.0 | 600.1 | 638.13 | 97.24 |
| Bi-LSTM | 462.1 | 404.1 | 664.3 | 903.7 | 1062.6 | 875.85 | 93.06 |
| Online-BO | 519.3 | 519.9 | 722.2 | 872.1 | 966.3 | 1274.75 | 95.15 |
마치며
이 연구는 SCIE급 인정 최상위 학회 ICSOC 2024에서 Distinguished Paper(Top 6)로 선정됐습니다. 특허 출원과 소프트웨어 저작권 등록을 마쳤고, 구현한 코드는 오픈소스로 공개했습니다.
사전 학습 없이 들어오는 요청 데이터로 예측 모델을 갱신하고, 부하 변화에 따라 threshold와 쿨 다운 타임을 조정했습니다. 실험에서는 응답 레이턴시와 자원 사용량을 함께 비교했습니다. 운영자가 정한 고정값에만 의존하지 않고, 실행 중 수집한 메트릭에 맞춰 스케일링 기준이 바뀌도록 구현한 연구입니다.