RAG Knowledge Base
Jira·Confluence·Git에 흩어진 지식을 매번 찾고 대조하던 비효율을 줄이기 위해 RAG 플랫폼을 구축했습니다. E2E 이후에도 남은 신규·변경 기능의 TC 구성과 검증에 활용하고, 개발자의 구현 지원과 기획 단계의 정책 누락·충돌 검토까지 확장했습니다.
흩어진 사내 지식을 연결해 QA·개발·기획에 활용한 RAG 플랫폼
각 팀별로 분산 관리 되었던 정책, 코드, 문서들
“그 스펙이 어디 있더라”, “이 버그, 어느 커밋이었지?” 개발자와 PO는 하루에도 몇 번씩 같은 정보를 다시 찾았습니다.
기능의 요구사항과 논의는 Jira에, 배경과 정책은 Confluence에, 실제 구현과 변경 이력은 Git에 있었습니다. 각 도구를 검색한 뒤, 문서의 정책과 티켓에서 바뀐 결정이 코드에도 반영됐는지 직접 대조해야 했습니다. AI 개발 도구를 사용할 때도 필요한 자료를 사람이 찾아 복사하고 붙이는 일이 반복됐습니다.
QA에서도 같은 문제가 있었습니다. E2E로 기본 기능의 반복 검증과 Google Sheets의 수기 작업은 많이 줄였지만, 신규·변경 기능의 요구사항을 읽고 영향 범위를 찾아 TC를 작성하는 일은 남아 있었습니다. 과거 버그나 다른 기능의 예외까지 고려하려면 다시 세 곳을 오가야 했고, 검증 범위는 담당자가 기억하는 내용에 영향을 받았습니다.
이렇게 자료를 찾고 대조하는 일을 줄이려고 사내 지식을 수집·검색하는 RAG 플랫폼을 구축했습니다. 먼저 QA에 적용했고, 이후 개발자가 구현 전에 관련 정책과 코드를 확인하고 기획자가 누락된 조건을 검토하는 데도 활용하도록 확장했습니다.
흩어진 정책·코드·문서를 한 번에 찾는 RAG 검색 플랫폼
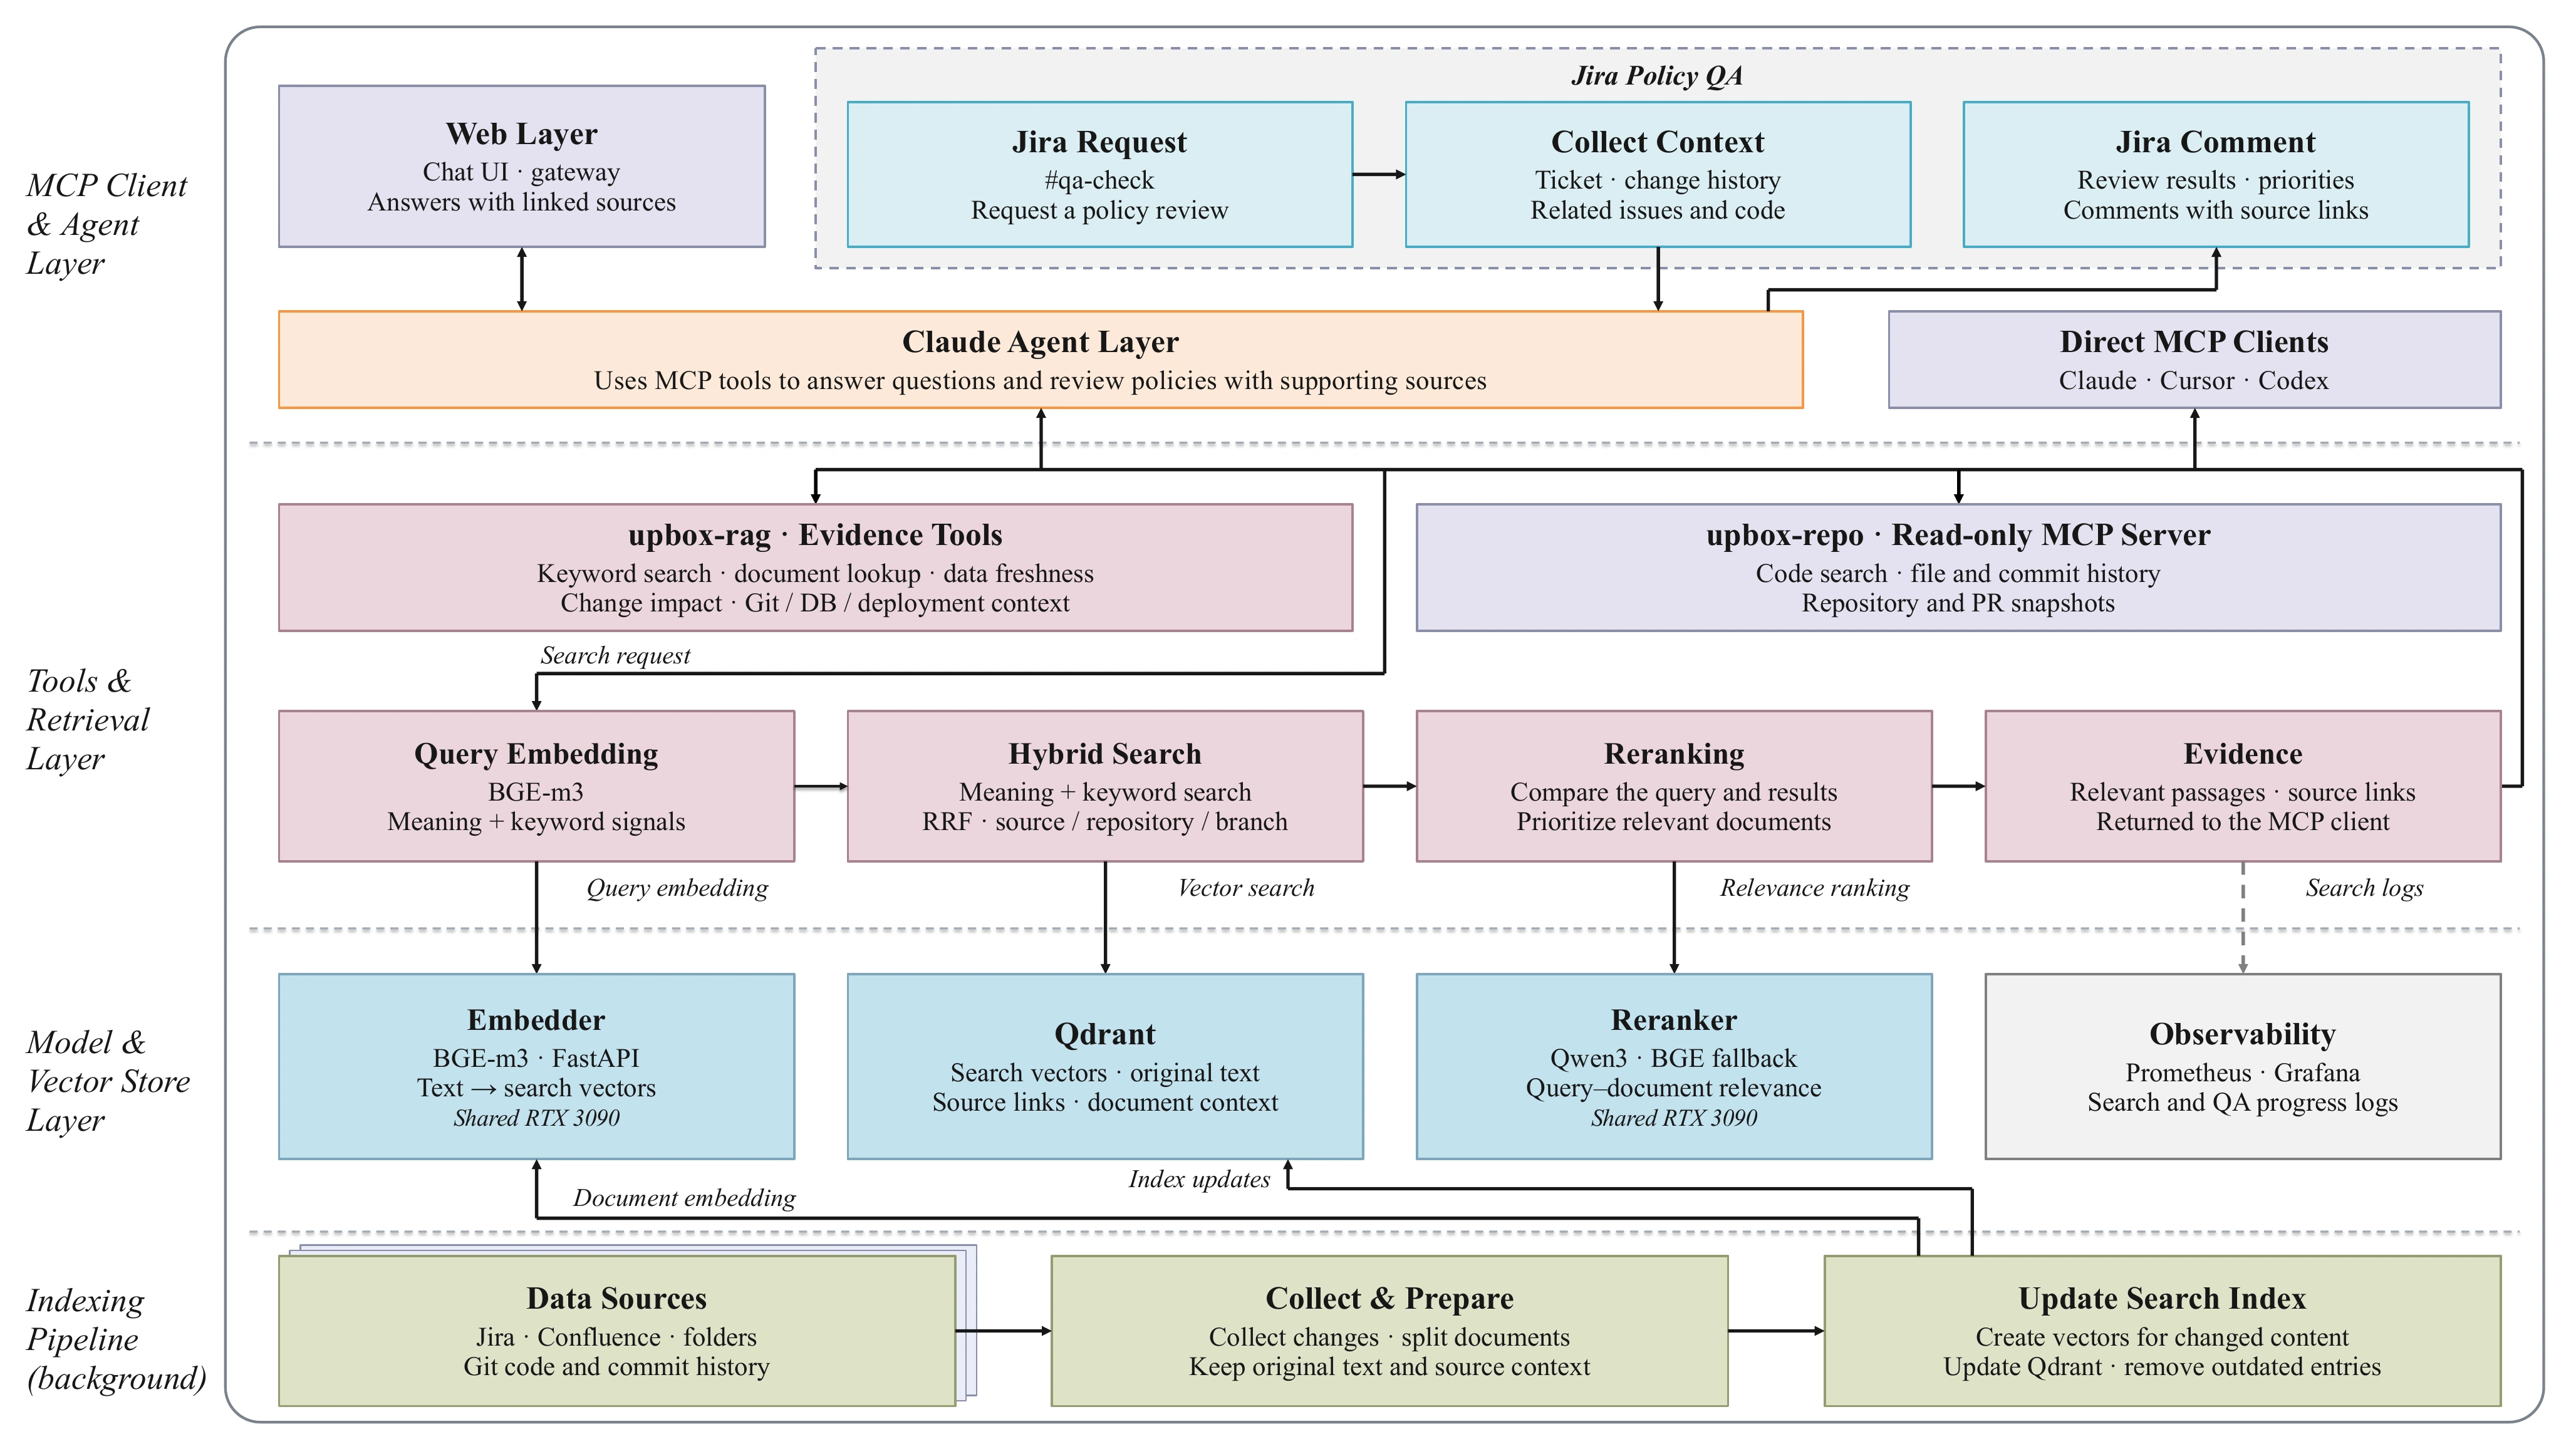
기존 Jira·Confluence·Git 커넥터를 바탕으로 티켓, 정책 문서, 코드와 커밋 이력, 축적된 검증 자료를 수집·색인했습니다. 질문 하나로 관련 자료를 함께 찾고, 정책이 바뀐 배경과 구현 내용을 대조할 수 있도록 구성했습니다.
서버는 Go, 수집·색인과 모델 서비스는 Python으로 구현했습니다. 검색 결과에는 원문 링크와 코드 위치를 붙였고, 클라이언트가 이를 읽어 TC와 답변을 구성하도록 역할을 나눴습니다. 자료를 찾고 복사하던 비효율을 줄이면서도 원문을 직접 확인할 수 있게 했습니다.
의미만 비슷한 문서에 정답이 밀리는 단순 벡터 검색
자료를 한곳에 모으더라도, 질문에 필요한 내용을 제대로 찾지 못하면 다시 사람이 뒤져야 합니다. 문장의 의미 유사도만으로는 그럴듯한 문서와 실제로 필요한 코드·예외 조건을 충분히 구분하기 어려웠습니다.
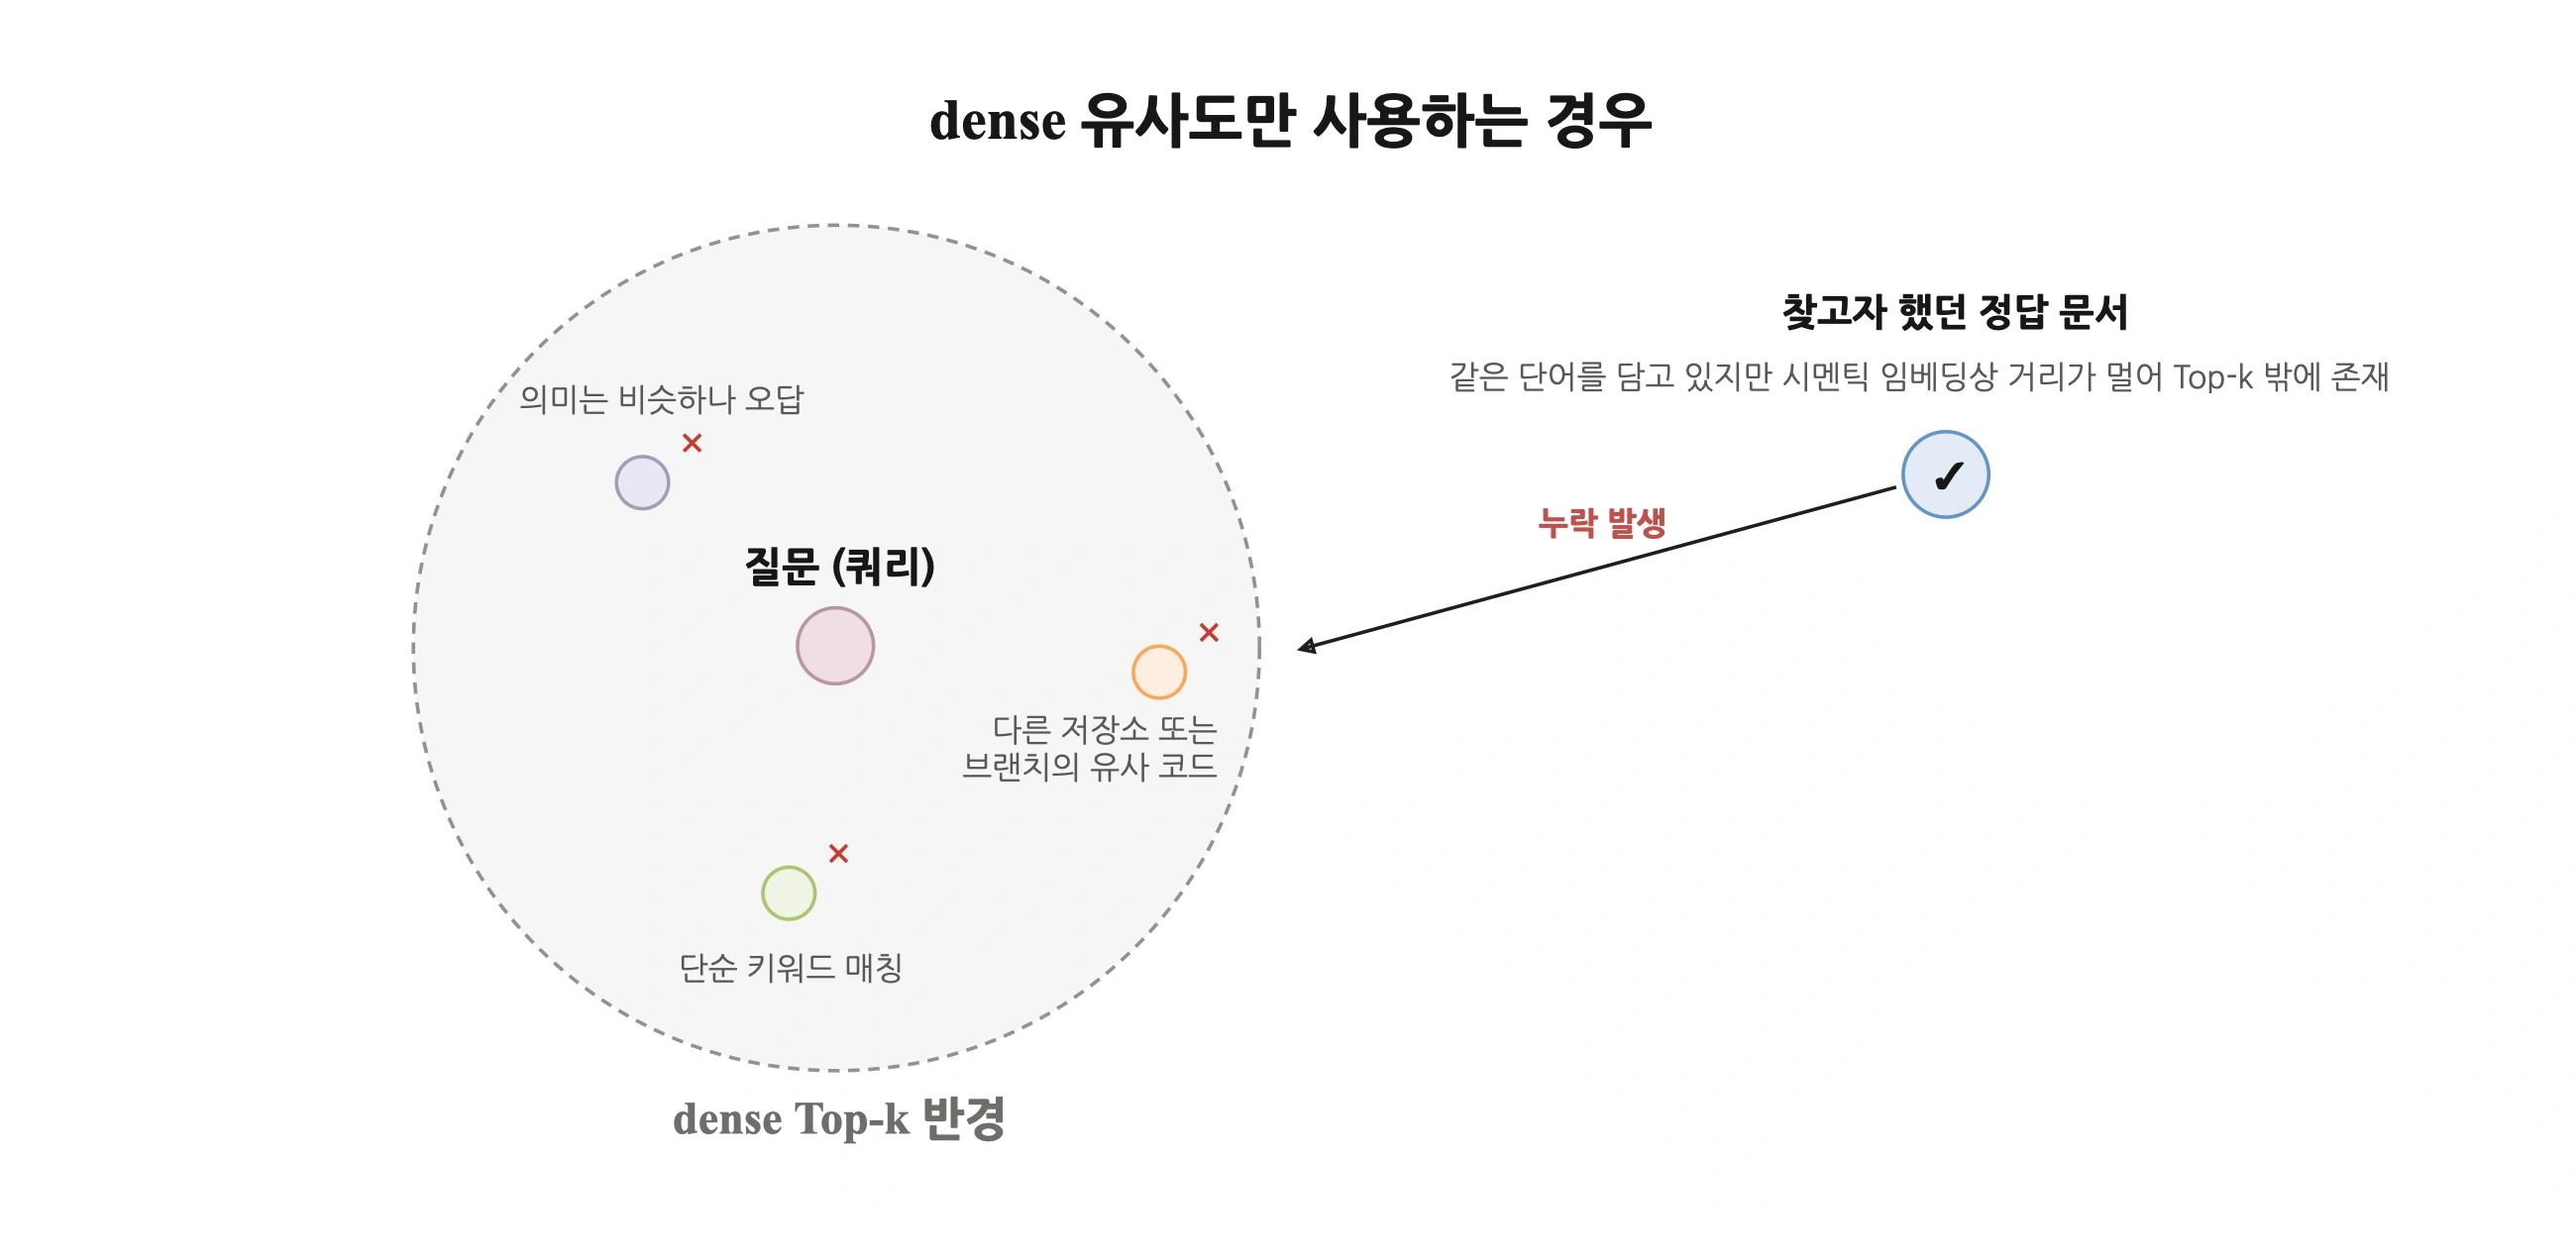
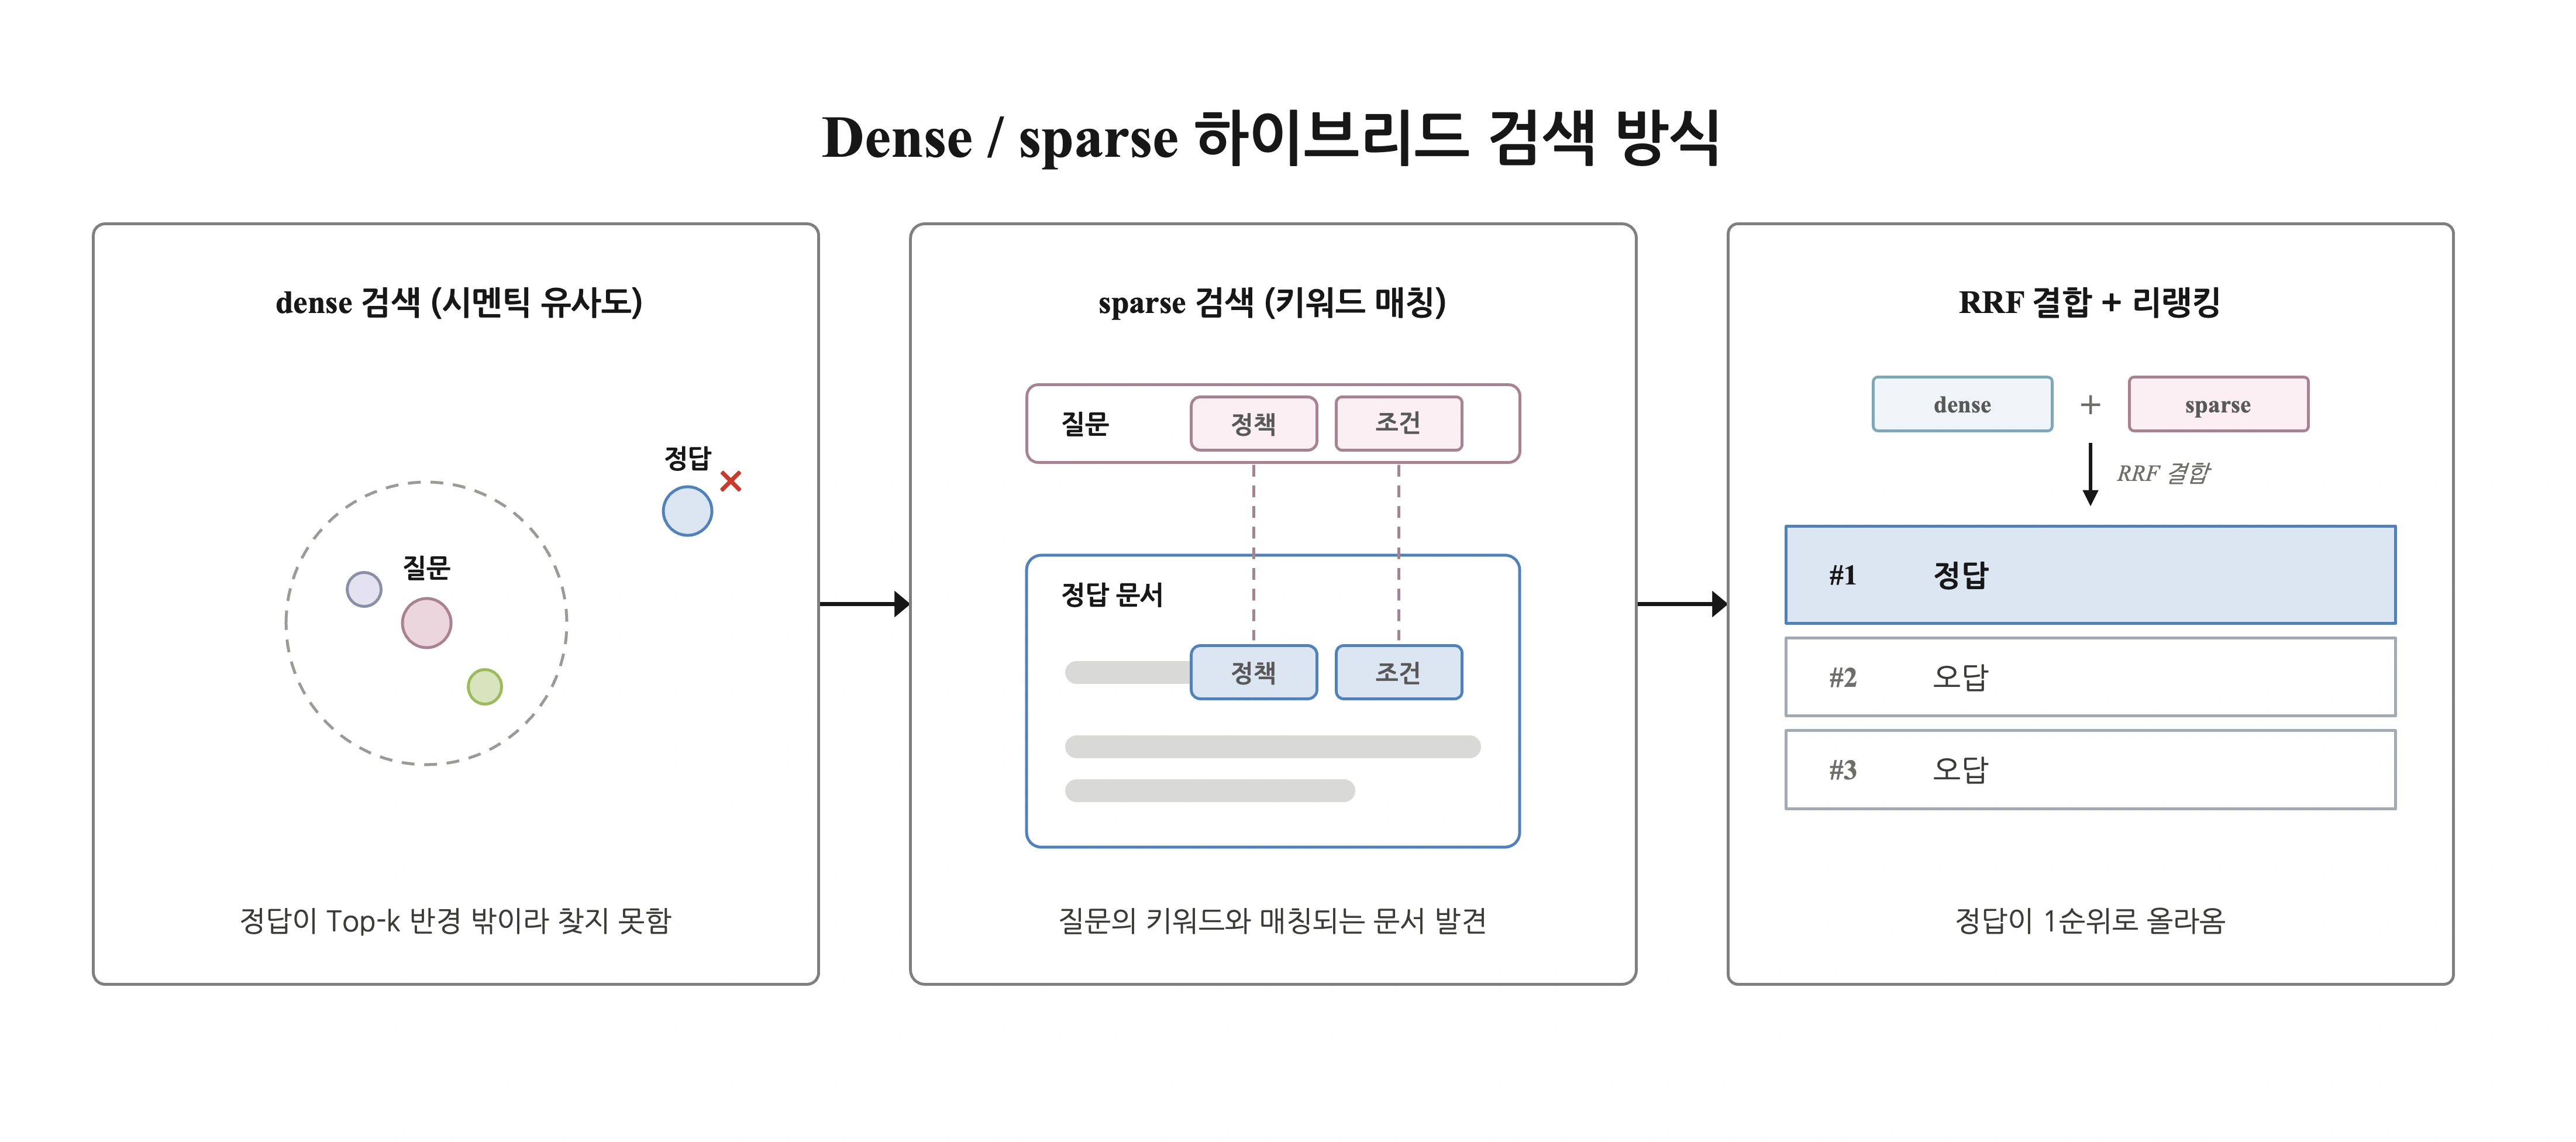
정책을 묻는 질문은 문서와 표현이 달라도 관련 내용을 찾아야 하지만, 코드나 오류를 찾을 때는 실제 사용된 용어를 놓치지 않는 것이 중요했습니다. 두 요구를 함께 다루기 위해 BGE-M3에서 dense·sparse 벡터를 함께 생성하고, 의미 중심 검색과 어휘 중심 검색을 병행했습니다. 두 검색은 점수 기준이 달라 단순히 더하기보다, 각 결과에서의 순위를 기준으로 결합하는 RRF를 Qdrant에서 적용했습니다.
다만 검색 결과를 합치는 것만으로는 질문에 필요한 조건이나 예외를 담은 문서가 상위에 온다고 보장할 수 없었습니다. 후보를 찾는 단계에서는 누락을 줄이고, 이후 cross-encoder가 질문과 후보 문서를 함께 읽어 관련성을 다시 평가하도록 나눴습니다. 모든 문서를 매번 정밀 비교하는 대신, 먼저 추린 후보에만 이 과정을 적용해 추가 연산의 범위를 제한했습니다.
검색 대상의 맥락도 중요했습니다. 비슷한 코드라도 다른 저장소나 개발 중인 브랜치의 내용이면 현재 기능을 판단하는 근거로 잘못 사용할 수 있어, 후보 검색에 저장소·경로·브랜치 조건을 적용했습니다. 반대로 티켓 번호나 함수명처럼 찾을 대상을 이미 아는 경우에는 의미 유사도를 계산할 필요가 없었습니다. 이런 조회는 임베딩과 리랭킹을 거치지 않는 별도 키워드 검색으로 분리했습니다.
관련성이 높은 결과를 늘리는 것만으로도 충분하지 않았습니다. 같은 문서의 비슷한 문단이 상위를 차지하면 함께 봐야 할 정책이나 코드가 밀릴 수 있기 때문입니다. 문서별 결과 수를 제한하고 소스별 후보를 확보해, 여러 자료를 대조해야 하는 질문에서 한 종류의 자료만 남지 않도록 보완했습니다.
의미(dense)와 어휘(sparse)를 함께 쓰는 이 방식이 실제로 어떻게 동작하고 나타나는지는, 아래 검색 흐름과 운영 인덱스의 벡터 분포에서 확인할 수 있습니다. 다만 실서버는 dense와 sparse를 각각 검색해 순위를 RRF로 합치므로 하이브리드는 원래 하나의 벡터가 아닙니다. 아래 그림에서는 비교를 위해 dense 벡터와, 희소한 sparse 벡터를 차원 축소(truncated SVD)한 값을 각각 정규화해 이어 붙인 근사 벡터로 하이브리드를 표현했습니다.
기본 기능은 E2E, 신규·변경 기능은 RAG로 나눈 검증
이렇게 찾은 자료를 실제 QA의 준비 과정에 연결했습니다. RAG로 요구사항·이전 버그·코드·검증 기록을 함께 확인하고, 역할·상태·경계값·예외·인접 기능의 회귀 범위를 정했습니다. 이후 브라우저에서 사용 흐름을 실행하고 API로 저장된 결과와 상태를 교차 확인했습니다. 재검증 때도 이전 재현 조건과 수정 의도를 다시 활용했습니다.
E2E는 기본 기능을 반복 확인하고, RAG는 새로 추가되거나 바뀐 기능의 TC 구성과 검증을 돕도록 사용했습니다. 새 정책이나 예외의 최종 판단은 제가 맡아, 실제 화면과 저장 결과까지 확인해 검증을 마쳤습니다.
E2E·TC·RAG 기반 검증과 Jira 후속 추적을 함께 운영하며, 초기 PO 3명이 릴리즈마다 1~2주 쓰던 QA를 현재는 혼자 평균 약 3일에 진행하고 있습니다. RAG는 이 과정에서 신규·변경 기능의 배경 조사와 검증을 보완했습니다.
자동 실행 환경과 실제 검증 흐름은 E2E QA Automation에서 이어집니다.
QA에서 쓰던 지식을 개발 단계까지
개발자가 구현 전에 관련 정책과 과거 버그를 확인할 수 있도록 RAG를 MCP로 제공했습니다. Claude·Codex 등 개발 환경에서 디펜던시, 변경 시점, 정책, 기존 사용처를 함께 조회해 구현 방향과 예상되는 버그를 검토하도록 했습니다.
개발 단계에서는 먼저 현재 코드를 보고 수정 계획을 세운 뒤, RAG가 과거 회귀 버그·관련 요구사항·다른 저장소의 사용처를 대조하도록 바꿨습니다. 계획을 바꿀 수 있는 근거는 최대 3개, 우선 확인 항목은 최대 5개로 제한했습니다. 새로운 근거가 없으면 검색을 계속 늘리지 않고 코드 수정·컴파일·테스트로 돌아가게 했습니다.
RAG 적용 후 최대 +6.7% 높아진 개발 구현 정확도
QA에서 쓰던 지식이 개발 결과물의 정확도까지 끌어올리는지 직접 측정했습니다. 배포된 백엔드 티켓을 수정 전 코드와 당시 확인할 수 있었던 지식으로 재구성하고, 기본 환경과 RAG·개발 지침·코드 구조 도구를 함께 적용한 환경에서 Opus와 Sonnet이 각각 결과물을 만들도록 했습니다. 고정된 LLM 평가자 3개가 같은 기능 기준으로 구현 결과물을 채점했습니다.
Opus
Sonnet
RAG를 함께 적용하자 Opus는 79.5점에서 84.8점, Sonnet은 78.2점에서 82.6점으로 올랐습니다. 각각 6.67%, 5.63% 개선입니다.
대신 개발 결과물 생성에 사용한 출력 토큰은 Opus 약 1.22배, Sonnet 약 1.16배로 늘었습니다. 그래서 모든 질문에 긴 검색을 적용하기보다, 수정 계획에 영향을 줄 근거를 우선 전달하고 이미 코드에서 확인한 내용은 반복 조사하지 않도록 했습니다.
코드가 나오기 전에 먼저 잡는 정책 누락과 모순
개발자가 요구사항대로 구현해도, 요구사항 자체에 빠진 조건이나 모순이 있으면 버그로 이어질 수 있습니다. 다음으로는 코드보다 앞에 있는 기획 티켓을 검토하도록 확장했습니다.
검토 요청 → 자료 확인 → 정책·구현 대조 → 결과 공유
-
Jira 댓글로 검토 요청
-
티켓과 연결된 자료 확인
-
명세와 실제 코드를 대조
-
같은 Jira 티켓에 결과 게시
기획자가 Jira 댓글에 #qa-check를 남기면 관련 정책과 기존 구현을 함께 검토하고, 같은 티켓에 결과를 받도록 워커를 구현했습니다. 본문만 읽어서는 논의 중 바뀐 결정을 놓칠 수 있어 댓글과 필드 변경 이력, 직접 연결된 티켓도 수집했습니다. PR 링크가 있으면 동기화된 PR head 코드까지 비교하고, 확인하지 못한 코드나 기준 브랜치는 미확인으로 남겼습니다.
코드는 검토 근거로 사용하되, 결과는 기획자가 결정할 수 있는 내용으로 정리했습니다. “어느 함수를 고쳐야 한다”보다 “어떤 조건의 정책이 빠졌고, 무엇을 정해야 하는지”를 우선순위와 출처 링크로 전달하도록 했습니다.
검토 모델에는 읽기 전용 도구만 제공하고 Jira 댓글 게시 권한은 워커에만 두었습니다. 요청 댓글의 공개 범위를 결과에도 유지하며, 요청 ID와 진행 상태를 SQLite에 저장해 재시작·재시도 때 같은 결과가 중복 게시되지 않도록 했습니다.
찾은 코드만으로는 알 수 없는 실제 배포 상태
QA와 개발, 기획에서 같은 지식을 활용하면서 “이 코드가 지금 테스트 환경에도 배포돼 있나?”까지 확인할 필요가 있었습니다. 코드나 커밋을 찾았다는 사실만으로는 답할 수 없습니다. 배포 버전과 DB 변경 이력을 별도의 읽기 전용 도구로 확인하도록 연결했습니다.
검색 자료 자체의 갱신 시점도 구분했습니다. 검색 서버와 주기적인 색인 작업을 분리하고, 문서 ID를 유지해 변경분을 동기화했습니다. 소스별 갱신 상태를 확인하고 기본 브랜치와 미병합 개발 브랜치를 나눠, 이전 자료나 진행 중인 구현을 현재 상태로 오해하지 않도록 했습니다.
임베더와 리랭커가 GPU 한 장을 함께 사용할 때는 공유 락으로 경합을 조정했습니다. 리랭커 장애 시에는 대체 모델이나 검색 결합 순위로 응답하도록 했습니다. Jira 워커는 요청 수집과 검토 실행을 분리하고, 실패한 작업은 최초 실행을 포함해 최대 5회만 시도하도록 했습니다. Prometheus·Grafana에서 검색 지연과 오류, 워커의 진행 상태·응답 중단·재시도 소진을 확인하도록 구성했습니다.
E2E에 RAG를 더한 뒤 7.0% → 3.0%까지 낮아진 배포 후 버그
RAG는 지금 QA 준비, 개발 구현, 기획 정책 검토에 실제로 쓰이고 있습니다. Jira·Confluence·Git에 흩어진 지식을 매번 다시 찾던 일을 줄이고, 신규·변경 기능의 배경을 한 번에 확인해 검증과 구현의 판단 근거로 삼습니다.
RAG를 쓰기 시작한 뒤로 버그를 앞단에서 더 많이 걸러냈습니다. 구현 전에 관련 정책과 과거 버그, 사용처를 먼저 확인해 놓치기 쉬운 회귀와 예외를 줄였고, QA에서도 신규·변경 기능의 배경을 함께 대조해 검증 범위를 넓혔습니다.
E2E로 반복 검증을 자동화해 하루 평균 검증량을 끌어올린 위에, RAG를 더한 뒤 배포 후 버그 비율이 한 단계 더 내려갔습니다. E2E 전·후, RAG 후 정규 배포를 같은 기준으로 비교하면 다음과 같습니다.
| 단계 | 하루 평균 검증량 | 배포 후 버그 비율 |
|---|---|---|
| E2E 전 | 22.3건/일 | 7.0% |
| E2E 후 | 29.2건/일 | 3.9% |
| RAG 후 | 33.9건/일 | 3.0% |